Архітектура SaaS на Azure: ізоляція, надійність та економіка одного клієнта
- Microsoft Azure
- Azure SaaS architecture
- multitenancy
- tenant isolation
- deployment stamps
- cloud architecture
- FinOps
- Azure monitoring
Архітектура SaaS на Azure: ізоляція, надійність та економіка одного клієнта
Платформа SaaS на Azure — це комерційна й операційна модель, втілена у хмарних ресурсах. Її архітектура має безпомилково розпізнавати клієнтську організацію, не допускати перетину встановлених меж даними, витримувати нерівномірне навантаження, розгортати зміни в усьому парку середовищ, відновлювати критичні сценарії після збоїв і давати змогу обґрунтувати собівартість кожного тарифу. Сам перелік продуктів Azure не розв’язує жодного із цих завдань.
Почніть із перевірених відомостей про бізнес: що саме вважається клієнтською організацією, як пов’язані організації та користувачі, у яких регіонах дозволено зберігати їхні дані, кому потрібні виділені ресурси, скільки коштує простій, як швидко слід відновлювати дані, які операції можуть зачекати та як обсяг використання впливає на ціну. Зафіксуйте очікувану кількість клієнтів, профіль навантаження, ризик впливу одного клієнта на інших, федерацію ідентичностей, вимоги законодавства й галузевих норм, тривалість підключення, модель підтримки та зобов’язання в разі припинення обслуговування.
Після цього оберіть найпростішу топологію, здатну виконати ці обіцянки. Спільні керовані служби часто забезпечують найкращу економіку на початковому етапі; дані, обчислювальні ресурси, передплати Azure або цілі осередки варто виділяти там, де ізоляція має вимірювану цінність. Принципи Azure Well-Architected утворюють систему взаємопов’язаних компромісів: додаткове резервування збільшує витрати, суворіша ізоляція ускладнює керування парком, а докладніша телеметрія впливає на конфіденційність і ціну. Наші послуги з архітектури та розробки Azure допомагають перетворити ці компроміси на план готової до експлуатації системи.
Складіть схему робочих потоків до вибору служб
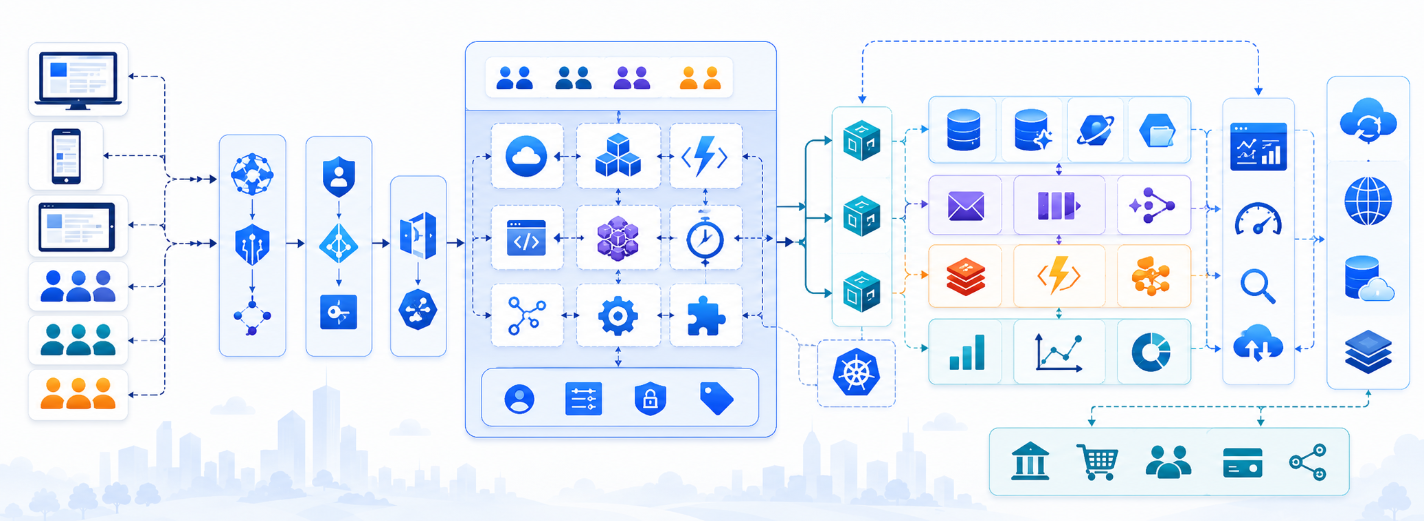
Складіть схему кожного критично важливого потоку — від точки входу до підтвердження результату. Запит із браузера може надходити через Azure Front Door, що забезпечує глобальну маршрутизацію, TLS, кешування та застосування правил WAF; далі він потрапляє до статичного сайту або середовища, яке формує сторінки на сервері, за потреби проходить через API Management із квотами й правилами життєвого циклу для партнерських продуктів, а потім надходить до App Service, Container Apps, Functions чи AKS. Обчислювальне середовище добирайте за характером навантаження та спроможністю команди його експлуатувати. Kubernetes виправданий лише тоді, коли його планування, мережеві можливості, переносність або засоби керування платформою розв’язують конкретне завдання.
Позначте основну систему обліку, кеш, Blob Storage, теми й черги Service Bus, виконавців фонових завдань, зовнішні служби, секрети та канал телеметрії. Синхронні операції мають завершуватися у строк, прийнятний для користувача. Тривалі або гарантовані операції передавайте через повідомлення з явним ідентифікатором завдання, ідемпотентністю, повторними спробами, опрацюванням непридатних повідомлень, визначеним порядком, скасуванням і звірянням результатів. Прийняття завдання до черги означає лише те, що воно очікує на виконання; це ще не підтвердження ділового результату.
Застосовуйте керовану ідентичність і Key Vault, щоб не копіювати облікові дані застосунків до файлів налаштувань. Відокремте площину керування від площини даних: перша відповідає за каталог клієнтів, їх розміщення, тарифи, права, підключення, призупинення та життєвий цикл осередків; друга виконує операції клієнтів. Для кожної межі опишіть можливі відмови, те, що побачить користувач, і спосіб, у який черговий фахівець усуне невизначеність. Узгодьте передплати Azure, групи керування, політики, мережу та базові засоби діагностики з цільовою зоною Azure.
Users and integrations
  │
Azure Front Door + WAF
  ├── Static frontend / SSR compute
  └── API Management when product policies require it
        └── Tenant router ── Control-plane catalog
              └── Assigned deployment stamp
                    ├── Managed compute
                    ├── Tenant-aware data and Blob Storage
                    ├── Service Bus ── Workers
                    ├── Key Vault via managed identity
                    └── Application Insights / Azure Monitor

Control plane
  ├── tenant identity, plan, entitlement, and stamp mapping
  ├── onboarding, movement, suspension, and deletion workflows
  └── capacity, versions, health, metering, and cost allocation
Зробіть ізоляцію клієнтів правилом продукту
Ізоляція клієнтів охоплює кілька вимірів: ідентифікацію, обчислення, мережу, дані, шифрування, телеметрію, експлуатаційні процедури та комерційні умови. Спільні ресурси дають змогу найефективніше використовувати потужності, але вимагають авторизації з обов’язковою перевіркою клієнта, належних умов відбору в запитах, обмеження частоти, квот і захисту від впливу навантаження одного клієнта на інших. Виділені бази даних, обчислювальні ресурси, групи ресурсів, передплати Azure чи осередки посилюють ізоляцію та дають змогу відновлювати середовище окремого клієнта. Водночас вони збільшують постійні витрати, час створення ресурсів і складність керування підключеннями, оновленнями та всім парком.
Визначайте контекст клієнта на основі перевіреного зіставлення з автентифікованим користувачем. Заголовок запиту може вказати одну з організацій, до яких належить користувач, але сам по собі ніколи не повинен надавати повноваження. Передавайте незмінний ідентифікатор клієнта через усі перевірки дозволів, сховища, ключі кешу, повідомлення, шляхи до файлів, записи аудиту, трасування та лічильники використання. Автентифікація підтверджує особу; авторизація має окремо довести, що цей суб’єкт може виконати саме цю дію над цим ресурсом у межах обраної організації.
Застосовуйте багаторівневий захист: обов’язкові фільтри за клієнтом у запитах, захист на рівні рядків бази даних там, де він доречний, окремі схеми чи бази, приватні мережі, вимоги до шифрування та автоматичні перевірки спроб прочитати або змінити дані іншого клієнта, звернутися до його кешу чи файлів, експортувати дані, діяти від імені служби підтримки або виконати фонове завдання. Переміщення й видалення клієнта мають бути заздалегідь спроєктованими процесами. Рівень ізоляції слід оформити як чітко визначену можливість тарифу з власною ціною та моделлю експлуатації, а не як поспішний виняток заради наступного великого контракту.
- Спільний рівень: багато клієнтів використовують ті самі обчислювальні ресурси та служби даних. Це зменшує постійні витрати, але вимагає найсуворішого контролю доступу, квот, обліку використання та захисту від впливу одного клієнта на інших. Постійно перевіряйте ізоляцію й справедливий розподіл ресурсів на навантаженнях, що відповідають типовим розмірам клієнтів. Кожне порушення меж реєструйте як інцидент безпеки, а непропорційне споживання ресурсів — як ваду правил продукту з визначеним відповідальним і строком усунення.
- Розділений рівень: обмежені групи клієнтів отримують окремі бази даних, пули, регіони чи осередки. Такий підхід зберігає переваги спільного використання ресурсів і водночас зменшує масштаб збоїв та проблем зі швидкодією. Правила розміщення мають ураховувати доступну потужність, регіон зберігання даних, версію й ризик.
- Виділений рівень: один клієнт отримує ізольовані ресурси, коли регуляторні вимоги, регіон зберігання даних, швидкодія, шифрування, відновлення або договірні умови виправдовують постійні витрати й складність керування парком. Автоматизація має підтримувати виділені середовища актуальними, спостережуваними та придатними до повної заміни.
- Змішаний рівень: площина керування призначає кожному клієнтові відповідний рівень і автоматизує розміщення, переміщення, оновлення, облік та весь життєвий цикл без ручних винятків. Для кожного рівня потрібні чітко оприлюднені умови та відповідальний за експлуатацію.
Використовуйте осередки розгортання як самостійні робочі комірки
Осередок розгортання — це незалежно керована копія визначеного набору ресурсів, яка обслуговує обмежену групу клієнтів. Осередки допомагають розподілити навантаження, коли досягнуто меж окремої служби, зберігати дані в потрібних регіонах, ізолювати клієнтів із регуляторними вимогами, обмежувати масштаб наслідків збою та підтримувати кільця поетапного розгортання. Їхня цінність полягає у відтворюваності та локалізації відмов, а не в ручному дублюванні ресурсів.
Площині керування потрібні єдиний достовірний каталог відповідності клієнтів осередкам, правила розподілу потужності й розміщення, стан підключення, перелік версій, відомості про справність, режим обслуговування та процедури переміщення. Трафік має надходити до правильного осередку, навіть якщо найближчий вузол мережі розташований в іншому місці. Визначте, що залишатиметься спільним для всієї платформи: часто це налаштування ідентифікації, каталог, виставлення рахунків або маршрутизація. Потім проаналізуйте, як відмова кожного такого компонента вплине на всі осередки. Спільна площина керування може стати найбільшим джерелом системного збою навіть в архітектурі з незалежних осередків.
Описуйте осередки в Bicep або Terraform і розгортайте їх за допомогою одного перевіреного автоматизованого процесу. Виносьте в параметри регіон, середовище, потужність, рівень ізоляції та дозволені відмінності, а налаштування безпеки, діагностики, резервного копіювання, політик та ідентичностей зберігайте однаковими. Впроваджуйте зміни поетапно, перевіряйте критичні сценарії клієнтів і автоматично зупиняйте розгортання в разі погіршення показників. Виявляйте розбіжності між фактичною та описаною конфігурацією й регулярно відпрацьовуйте заміну осередку: якщо його неможливо передбачувано відтворити, це лише набір унікальних серверів, перенесений у хмару.
targetScope = 'subscription'

param environment string
param region string
param stamp string
param isolationTier string

resource stampGroup 'Microsoft.Resources/resourceGroups@2024-03-01' = {
  name: 'rg-saas-${environment}-${region}-${stamp}'
  location: region
  tags: {
    workload: 'saas'
    environment: environment
    region: region
    stamp: stamp
    isolationTier: isolationTier
    costOwner: 'product'
  }
}

module workload './modules/workload-stamp.bicep' = {
  name: 'workload-${stamp}'
  scope: stampGroup
  params: { environment: environment, region: region, stamp: stamp }
}
Будуйте відновлення та спостережуваність навколо клієнтських сценаріїв
Визначте цілі надійності для ключових сценаріїв клієнта ще до вибору способу резервування. Зони доступності захищають від відмов на рівні центру оброблення даних. Відновлення після збою цілого регіону розв’язує інше завдання й потребує реплікації даних, маршрутизації, достатнього запасу потужності, доступу до секретів і залежностей, а також чіткого рішення щодо припустимої втрати даних. Встановіть RPO та RTO для кожного набору даних і кожної операції, а потім перевірте відновлення з резервної копії та перемикання між регіонами. Резервний регіон, який простоює й ніколи не обробляв навантаження, подібне до робочого, — це неперевірене припущення, а не надійний засіб відновлення.
Передавайте ідентифікатори операції, клієнта, осередку, регіону, версії, користувача та повідомлення через виклики HTTP, фонові завдання й зовнішні служби. За допомогою Application Insights, Azure Monitor і OpenTelemetry відстежуйте затримки, помилки, насичення ресурсів, час перебування завдань у черзі, поведінку залежностей і частку клієнтів, які успішно завершують критичні сценарії. Оцінюйте загальний стан платформи окремо від впливу на конкретного клієнта: проблема з навантаженням лише в одній організації також може бути інцидентом, навіть якщо вона не змінює середнього показника для всієї системи.
Захищайте конфіденційність і контролюйте витрати, не втрачаючи можливості діагностувати збої. Не записуйте секрети чи вміст даних клієнтів до журналів; класифікуйте поля, керуйте доступом, налаштовуйте вибірку відповідно до цінності сигналу, а строк зберігання — до потреб розслідування та регуляторних вимог. Для кожного сповіщення визначте відповідального, обґрунтуйте поріг, підготуйте інструкцію реагування та опишіть вплив події на клієнтів. Відпрацьовуйте відмову залежності, завершення строку дії облікових даних, вичерпання квоти, невдале розгортання, пошкоджені повідомлення, відновлення й перемикання. Завдання спостережуваності Azure — скоротити час до правильного рішення в умовах інциденту.
Пов’яжіть витрати Azure з економікою SaaS
Мітки дають змогу визначити відповідального за ресурс, середовище, регіон та осередок, але не розподіляють між клієнтами всі спільні витрати. Додайте облік тих одиниць продукту, які формують витрати й цінність: збережених байтів, повідомлень, активних облікових записів, токенів моделей, вивантажень, ресурсомістких операцій або іншого обґрунтованого показника. Поєднайте відомості про використання з витратами Azure та даними про тарифи, щоб розрахувати собівартість за клієнтом, тарифом, функцією, сценарієм і осередком.
Чітко сформулюйте правила розподілу. Виділені ресурси безпосередньо відносьте до відповідного клієнта; спільні постійні витрати та витрати на платформу розподіляйте за задокументованою методикою; окремо показуйте невикористану потужність, запас для зростання, підтримку й одноразові витрати на перенесення. Аналізуйте весь розподіл валової маржі, а не лише середнє значення: кілька клієнтів із нетиповим навантаженням можуть непомітно поглинути маржу цілого тарифу.
Використовуйте бюджети, сповіщення про аномалії, правила життєвого циклу сховищ, добір оптимального розміру ресурсів, межі автоматичного масштабування, а для стабільного базового навантаження — резервування чи плани заощаджень. Системні перевитрати усувайте змінами в архітектурі. Кожний спосіб економії оцінюйте разом із його впливом на надійність, безпеку, швидкодію та обсяг експлуатаційної роботи. Відмова від резервної потужності, зменшення бази даних під середнє навантаження або надмірна вибірка, через яку з журналів зникають рідкісні збої, можуть зменшити рахунок, але збільшити втрати бізнесу. Якісна архітектура SaaS робить ефективне спільне використання ресурсів звичним вибором, а виняткову ізоляцію оцінює за її справжньою вартістю.
Огляд архітектури SaaS на Azure
- Достовірність контексту клієнта: Чи визначається контекст клієнта за надійними даними про особу та чи послідовно перевіряється він під час авторизації, у запитах, ключах кешу, файлах, повідомленнях, телеметрії, засобах підтримки й процесах видалення? Доведіть це автоматичними спробами перетнути межі через кожний канал передавання даних і привілейований шлях працівника.
- Цілісність потоків: Чи простежено синхронні запити, тривалі завдання, файли, зворотні виклики, повторні спроби, неоднозначні результати, дії працівників і видимі користувачеві стани від точки входу до підтвердження результату? Перевірте поведінку системи для дубльованих, затриманих, переставлених, частково виконаних і остаточно невдалих операцій.
- Оновлення парку: Чи можна керувати інфраструктурою, осередками, підключенням клієнтів, змінами схеми, поетапним розгортанням, відкатом, виявленням розбіжностей і заміною за допомогою перевіреної автоматизації? Відтворіть осередок із коду та порівняйте політики, ідентичності, діагностику, резервні копії й поведінку застосунку.
- Відновлення: Чи визначено для критично важливих сценаріїв SLO, RPO, RTO, межі потужності, режими відмови, перевірені процедури відновлення й перемикання, роботу в обмеженому режимі, відповідальних та актуальні інструкції? Після кожного навчання фіксуйте фактичний час відновлення, втрату даних, ручні дії та порядок інформування клієнтів.
- Економіка: Чи може команда пояснити використання, надійність, витрати Azure, невикористану потужність, особливі рівні ізоляції та валову маржу за клієнтом, тарифом, функцією й осередком? Визначте, хто аналізує відхилення та які рішення щодо ціни, потужності чи архітектури ухвалюють на основі кожного показника.
Чи потрібні кожному клієнтові SaaS виділені ресурси Azure?
Чи потрібні кожному клієнтові SaaS виділені ресурси Azure?
Чи варто платформі SaaS на Azure починати з AKS?
Чи варто платформі SaaS на Azure починати з AKS?
Що робить осередок розгортання корисним?
Що робить осередок розгортання корисним?
Як розподіляти витрати SaaS на Azure?
Як розподіляти витрати SaaS на Azure?
Перетворіть вимоги SaaS на Azure на архітектуру, яку можна перевірити
Надайте модель клієнтів, схеми руху даних, рівні ізоляції, перелік регіонів, цілі відновлення, фактичні дані про навантаження та логіку ціноутворення. Ми визначимо найпростішу безпечну архітектуру Azure і перелік перевірок, необхідних перед запуском робочого середовища.
Публікації
Наші дослідження
Дослідження та розробка рішень на основі штучного інтелекту для оптимізації бізнес-процесів і підвищення ефективності прийняття рішень.
Аналіз моделей машинного навчання для прогнозної аналітики у фінансовій сфері, електронній комерції та SaaS-платформах.
Дослідження технологій обробки природної мови та комп'ютерного зору для посилення автоматизації, персоналізації та підтримки клієнтів.
Посібник із розроблення та архітектури в Microsoft Azure
Практичний посібник з обчислень, даних, мережі, ідентифікації, надійності, автоматизації випуску, спостережуваності, контролю витрат і перенесення робочих навантажень в Azure.
12 хв читання
25 Jul 2026
Упровадження Azure: контрольний список перенесення та поширені помилки
Практичний контрольний список перенесення до Azure: облік робочих навантажень, базове середовище, стратегія, ідентичності, дані, етапи перенесення, відновлення, швидкодія, витрати й відповідальність за експлуатацію.
8 хв читання
04 Aug 2026
Архітектура застосунків Azure: розроблення, постачання й експлуатація
Проєктуйте застосунки Azure як цілісну операційну систему: керована хмарна основа, вибір служб за вимогами навантаження, захищені посвідчення, поетапна модернізація, інфраструктура як код, поступове постачання, спостережуваність, стійкість і відповідальне керування витратами.
9 хв читання
05 Aug 2026