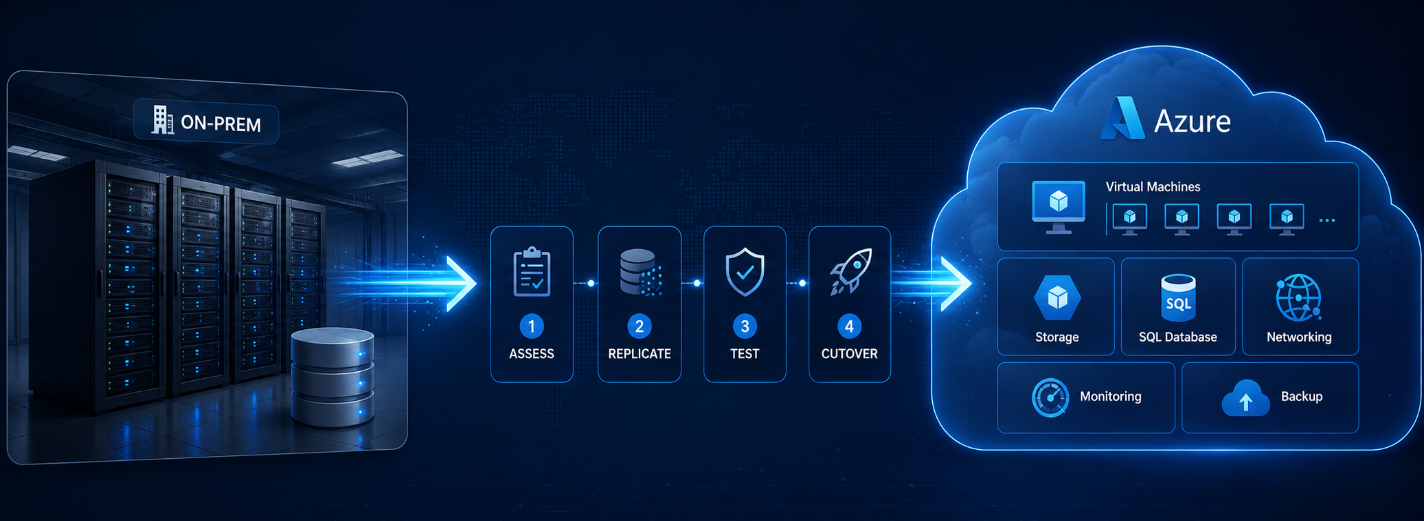
Упровадження Azure: контрольний список перенесення та поширені помилки
- Azure Cloud
- Cloud Migration
- Cloud Implementation
- Cloud Architecture
Упровадження Azure: контрольний список перенесення та поширені помилки
Упровадження Azure — це зміна моделі роботи, яка лише зовні нагадує інфраструктурний проєкт. Перенесення системи змінює керування ідентичностями, мережу, розгортання, спостереження, відновлення, розподіл витрат і межі відповідальності між командами програм та платформи. Просте копіювання серверів здатне перенести технічний борг у гнучкішу модель оплати, не поліпшивши ані надійності, ані швидкості випуску змін.
Починайте з ділових результатів і вимог кожного робочого навантаження. Визначте клієнтські сценарії в межах перенесення, цільові показники доступності й затримки, допустимий час відновлення та втрату даних, класифікацію й місце зберігання даних, очікуваний попит, частоту змін, години підтримки, регуляторні обов’язки, межі бюджету й відповідального, який може погодити компроміс. Використовуйте складники Azure Well-Architected Framework — надійність, безпеку, оптимізацію витрат, досконалість експлуатації та ефективність швидкодії — як ракурс перевірки, але приймайте рішення для конкретного навантаження, а не перетворюйте настанови на таблицю балів.
Цей контрольний список веде від дослідження й вибору стратегії до керованого базового середовища, поетапного перенесення та перевіреної експлуатації. Він віддає перевагу оборотним крокам, доказам із робочої системи й чіткій відповідальності. Перенесення завершене тоді, коли система виконує погоджені цілі обслуговування й вартості в Azure, а експлуатаційна команда здатна самостійно розгортати, спостерігати, відновлювати й удосконалювати її без залежності від проєкту перенесення.
Облікуйте робочі навантаження, залежності й ділові зобов’язання
Створіть перелік робочих навантажень, а не тільки серверів. Для кожного зафіксуйте ділового відповідального, користувачів, критично важливі сценарії, середовища, сховище вихідного коду, середовище виконання, сховища даних, ідентичності, сертифікати, секрети, вхідні й вихідні потоки, DNS, інтеграції, заплановані завдання, засоби експлуатації, ліцензійні обмеження, стан підтримки, поведінку на піку, вартість і зобов’язання перед клієнтами. Простежуйте залежності за реальним трафіком, налаштуваннями, даними спостереження та розмовами з командою: схеми часто не показують ручних робіт і старих з’єднань.
Визначте критичність і готовність до перенесення. Зафіксуйте початкові показники затримки, помилок і вичерпання ресурсів, історію інцидентів, частоту розгортань, успішність резервного копіювання й докази відновлення. Знайдіть непідтримувані системи, невизначену відповідальність, зашиті в код адреси, локальний стан, спільні бази даних, привілейовані службові облікові записи, дозволені переліки мережевих адрес і постачальників, яких потрібно повідомити. До вибору регіону чи способу передавання даних позначте їхню чутливість, строки зберігання, вимоги суверенітету й обов’язки щодо видалення.
Групуйте залежності навколо ділових операцій. Клієнтська програма, API, постачальник ідентифікації, черга, база даних і стороння служба можуть потребувати одного етапу перенесення, навіть якщо працюють на різних вузлах. Назвіть зв’язки, які мають зберегтися через межу між локальною та хмарною частинами, і виміряйте їхню затримку та поведінку під час відмови. Для кожного невідомого призначте відповідального й дату з’ясування; невідомі не повинні мовчки ставати припущеннями під час перемикання.
Оберіть окрему стратегію перенесення для кожного навантаження
Обирайте долю кожного навантаження на підставі доказів. Перенесення майже без змін дає змогу швидко зменшити залежність від власного центру обробки даних, але зазвичай зберігає недоліки експлуатації. Перехід окремих функцій до керованих служб Azure передає частину відповідальності платформі, проте потребує підтвердження сумісності, швидкодії та вартості. Перебудова коду чи архітектури може поліпшити економіку продукту й стійкість, якщо це виправдано комерційно, але поєднання великого перепроєктування з незмінним строком перенесення різко збільшує невизначеність. Заміна, виведення з експлуатації або збереження на місці теж є правильними рішеннями, коли їх підтримують цінність, права власності й обмеження.
Порівнюйте варіанти за однаковими критеріями: перериванням роботи, переміщенням даних, межею безпеки, ліцензуванням, спроможністю інженерної команди, наявністю навичок, можливістю повернення, тягарем експлуатації, очікуваною вартістю й часом до отримання користі. Створіть невеликий технічний прототип для найризикованішого припущення, наприклад поведінки бази даних, затримки мережі, об’єднання систем ідентифікації, роботи з файлами чи сумісності постачальника. Обирайте службу не через її новизну, а як найпростішу модель, що виконує цілі навантаження й доступна відповідальній команді в експлуатації.
Перетворіть сукупність систем на послідовні етапи. Почніть із показового навантаження, відмова якого не матиме непоправних наслідків, а висновки допоможуть удосконалити базове середовище. Переносьте тісно пов’язані складники разом, установіть критерії входу й завершення, передбачте період стабілізації та не плануйте кілька критичних перемикань на тих самих чергових фахівців. Кожному етапу потрібні дата рішення, відповідальний, план спілкування, звірення даних і працездатний спосіб повернутися або виправити систему без відкату.
- Перенесення без істотних змін: обирайте його, коли строк важливіший за модернізацію, а команда свідомо приймає збережений операційний борг.
- Перехід на керовані служби: передавайте платформі окремі функції після перевірки сумісності, швидкодії, відновлення, вартості й навичок експлуатації.
- Перебудова коду чи архітектури: змінюйте межі програми, коли вимірювана користь для продукту, масштабування, стійкості або постачання виправдовує додатковий ризик перенесення.
- Заміна, виведення або збереження: не переносьте навантаження, якщо його цінність, права власності, стан підтримки чи обмеження свідчать на користь іншого продукту або керованого завершення.
Спочатку створіть базове середовище та захистіть ідентичності й дані
Створіть базове середовище Azure до надходження робочих навантажень. Спроєктуйте межі груп керування й передплат, регіони, топологію мережі, DNS, гібридне з’єднання, ідентичності, політики, журналювання, спостереження за безпекою, упорядкування ресурсів та аварійний доступ. Опишіть основу як версійований код інфраструктури з перевіркою змін і відтворюваними середовищами. Відокремте засоби керування платформою від налаштувань робочого навантаження, щоб відповідальність і винятки залишалися зрозумілими.
Використовуйте ідентичності Microsoft Entra, керовані ідентичності та найменші необхідні права скрізь, де це підтримує навантаження. Захищайте привілейовані ролі посиленою автентифікацією, підвищенням прав на обмежений час і контрольованим аварійним доступом. Зберігайте секрети та ключі в керованих сховищах, визначте їхню заміну й вилучіть облікові дані з коду та процесів розгортання. Моделюйте довіру між людьми, службами, обліковими записами розгортання й операторами підтримки: приватне мережеве підключення не виправляє слабкої перевірки прав у програмі.
Класифікуйте дані й позначте весь їхній життєвий цикл: збирання, передавання, зберігання, копіювання, резервування, аналітику, вивантаження, видалення та обов’язкове зберігання за законом. Обирайте шифрування й власника ключів, мережевий доступ, журнали аудиту, маскування та адміністративні шляхи відповідно до моделі загроз і зобов’язань. Перевірте цільове середовище й засіб передавання на типовому обсязі, швидкості змін і відмовах. Призупиняйте лише ті зміни, без яких неможливе перемикання, звіряйте записи й зберігайте простежувані докази.
Перевірте швидкодію, перемикання та відновлення за доказами
Визначте здоровий стан системи до випробувань. Використовуйте трафік, розподіл даних і кількість одночасних запитів, подібні до робочих, щоб виміряти процентилі затримки, пропускну здатність, частоту помилок, вичерпання ресурсів, глибину черг та обмеження залежностей. Перевірте сталий рівень, піки, швидке зростання й обмежену зовнішню службу. Порівняйте результати з початковими показниками та цілями обслуговування: успішна відповідь HTTP за малого штучного навантаження ще не доводить достатньої місткості.
Відрепетируйте перемикання за оперативною інструкцією з точним часом. Охопіть резервні копії, відставання реплікації, перевірку даних, налаштування, зміни DNS і сертифікатів, короткі перевірки основних функцій, приймання бізнесом, спілкування, пороги повернення й особу, уповноважену приймати рішення. Перевірте безпечне повторення без дублювання результату та звірення, якщо старий і новий шляхи можуть одночасно обробляти роботу. Зберігайте можливість відновити старе середовище до виконання критеріїв завершення, а потім свідомо вилучіть маршрути й облікові дані.
Доведіть відновлення, а не просто наявність резервних копій. Відновіть типові системи й дані в ізольованому середовищі, виміряйте фактично досягнуті RTO і RPO, перевірте залежності та доручіть процедуру майбутній експлуатаційній команді. Відпрацюйте відмову зони або служби на рівні, відповідному критичності. Панелі стану, сповіщення, журнали, простеження запитів, виклик чергових та інструкції з виправлення мають працювати до завершення роботи команди перенесення.
Поширені помилки перенесення до Azure та їхні наслідки
Найпоширеніша помилка — вважати створення ресурсів поступом перенесення. Команди розгортають робочі системи до того, як погоджено керування ідентичностями, політики, мережеву відповідальність, журналювання й розподіл витрат, а потім поспіхом додають засоби контролю. Інша помилка — переносити всі навантаження за одним шаблоном: зберігати без змін системи, які слід закрити, перебудовувати сталі системи без ділового обґрунтування або впроваджувати складні керовані служби раніше, ніж команда навчиться їх експлуатувати.
Дані та залежності спричиняють тихіші відмови. Неповний перелік не враховує пакетне завдання, дозволений перелік IP-адрес, сертифікат, потік звітних даних або ручний крок підтримки. План передавання вимірює байти, але ігнорує швидкість змін, звірення, строки зберігання й повернення. Одночасне велике перемикання пов’язує незалежні ризики та виснажує фахівців реагування. Випробування швидкодії використовують середні дані, хоча справжню межу визначає найбільший клієнт або оброблення наприкінці місяця.
Експлуатаційні помилки проявляються після запуску: ручні зміни робочої системи, сповіщення без відповідального, жодного перевіреного відновлення, спільні облікові дані адміністраторів, необмежені журнали, відповідальність за оновлення між командами й відсутність реакції на перевищення бюджету. Запобігайте їм за допомогою опису інфраструктури як коду, політик, призначеного власника служби, доказів випуску, навчань із відновлення, моделі підтримки й перегляду після кожного етапу. Кожен виняток потребує відповідального, строку дії та додаткового засобу захисту.
Керуйте витратами через архітектуру й відповідальність
Створіть модель витрат до перенесення. Пов’яжіть одиниці попиту — операції, клієнтські середовища, користувачів, обсяг даних, звернення до моделей або завдання — з витратами на обчислення, зберігання, мережу, керовані служби, безпеку, спостереження, підтримку й ліцензії. Змоделюйте звичайну, пікову й аварійну місткість, зростання даних, резервні копії, передавання між регіонами та назовні, неробочі середовища, довгострокові зобов’язання й податки. Порівнюйте варіанти за сукупною вартістю навантаження та користю для бізнесу, а не лише за ціною віртуальної машини.
Ще в базовому середовищі впровадьте позначки або інші відомості для розподілу витрат, бюджети, сповіщення про відхилення й призначену відповідальність. Поєднуйте дані про витрати Azure з відомостями програми, щоб команда могла пояснити, яка поведінка продукту спричинила зміну. Переглядайте невикористовувані ресурси, надмірну місткість, рівні зберігання, строки утримання, резервування чи довгострокові знижки та архітектурні осередки витрат. Зобов’язуйтеся на строк лише після встановлення сталого рівня використання: знижка не повинна приховувати невизначений попит або заважати очікуваній перебудові.
Оптимізація витрат — це постійне інженерне рішення. Зменшення надлишковості може зашкодити надійності, надто агресивне автоматичне масштабування — збільшити затримку, надмірне спостереження — стати дорогим, а недостатнє — підвищити вартість інциденту. Установлюйте обмеження вартості одиниці разом із цілями обслуговування. Кожна пропозиція оптимізації має називати очікувану економію, вплив на навантаження, вартість упровадження, період перевірки й спосіб повернення.
Успішне перенесення до Azure залишає систему, яку команда-одержувач здатна самостійно розгортати, спостерігати, відновлювати, захищати й фінансувати відповідно до вимірюваних цілей бізнесу.— GARNO.TECH
Переносьте обмеженими етапами й доводьте успіх кожного
Погоджуйте кожен етап лише тоді, коли перелік, залежності, стратегія, цільова архітектура, засоби захисту й контролю даних, підтверджена достатність ресурсів, відновлення, експлуатація, відповідальність за витрати та можливість повернення відповідають визначеним критеріям. Фіксуйте прийнятий ризик і винятки. Після перемикання проведіть перевірку стабільності за реальними даними системи й результатами для клієнтів; закривайте етап лише після того, як команда-одержувач візьме на себе розгортання, інциденти, відновлення й витрати.
Перетворюйте висновки на вдосконалення самої системи перенесення. Після кожного етапу оновлюйте модулі базового середовища, політики, оперативні інструкції, оцінки й навчання. Не розширюйте обсяг, якщо докази викрили хибне припущення. Малий етап, що показує, як організація насправді експлуатує Azure, цінніший за швидке передавання з крихкою відповідальністю. Вимірюйте, чи стають наступні етапи безпечнішими, швидшими й передбачуванішими; інакше програма повторює дії замість нарощування спроможності.
GARNO.TECH може оцінити сукупність систем, спроєктувати базове середовище та архітектуру навантажень, упровадити автоматизацію, виконати обмежене перенесення або перевірити програму клієнта в межах розроблення в хмарі Azure. Після співпраці мають залишитися записи рішень, облікові записи під контролем клієнта, відтворювана інфраструктура, докази експлуатації та зрозумілий шлях для наступного навантаження.
Контрольний список перенесення до Azure у чотири етапи
- /01Дослідіть і визначтеПозначте ділові сценарії, робочі навантаження, залежності, дані, відповідальність, поточні показники й зобов’язання; визначте істотні цілі обслуговування, безпеки, відновлення та вартості.
- /02Підготуйте основуДо появи робочих систем створіть кероване базове середовище, ідентичності, з’єднання, політики, спостереження, автоматизоване розгортання, розподіл витрат і відповідальність за експлуатацію.
- /03Доведіть і перенесітьПеревірте найризикованіші припущення, відрепетируйте передавання й відновлення, а потім виконайте обмежений етап зі звіренням, прийманням з боку бізнесу й визначеними порогами повернення.
- /04Стабілізуйте й удоскональтеОцініть реальні результати обслуговування й витрат, передайте експлуатацію, закрийте винятки, оновіть повторно використовувані засоби контролю та погоджуйте наступний етап за новими доказами.
Чи слід переносити всі робочі навантаження до Azure одним етапом?
Чи слід переносити всі робочі навантаження до Azure одним етапом?
Плануйте перенесення до Azure за доказами робочого навантаження
Підготуйте перелік навантажень, ділові цілі, карту залежностей, зобов’язання щодо обслуговування, обмеження даних, поточні витрати й цільовий строк. Ми визначимо найризикованіші припущення та спроєктуємо обмежений перший етап із критеріями приймання, відновленням, відповідальністю й контролем витрат.
Публікації
Наші дослідження
Дослідження та розробка рішень на основі штучного інтелекту для оптимізації бізнес-процесів і підвищення ефективності прийняття рішень.
Аналіз моделей машинного навчання для прогнозної аналітики у фінансовій сфері, електронній комерції та SaaS-платформах.
Дослідження технологій обробки природної мови та комп'ютерного зору для посилення автоматизації, персоналізації та підтримки клієнтів.
Модульний моноліт на NestJS: практичний посібник з архітектури
Спроєктуйте модульний моноліт на NestJS із межами предметних областей, вузькими відкритими API, відповідальністю за дані, локальними транзакціями, надійними подіями та обґрунтованим виділенням служб.
8 хв читання
08 Sep 2026
Створення корпоративного продукту на Angular: від робочого процесу до надійної експлуатації
Практичний посібник зі створення корпоративних застосунків на Angular через моделювання процесів, межі функціональних модулів, угоди інтеграцій, відповідальність команд, вимірювану якість, поетапні випуски й виробничу експлуатацію.
9 хв читання
01 Aug 2026
Як DevOps і хмара Azure утворюють придатну до експлуатації платформу постачання
Поєднайте архітектуру Azure з інфраструктурою як кодом, захищеною CI/CD, поступовим випуском, ідентичністю навантаження, спостережуваністю, реагуванням на події, масштабуванням і FinOps.
9 хв читання
04 Aug 2026