Как DevOps и облако Azure образуют пригодную к эксплуатации платформу поставки
- Azure Cloud
- DevOps
- Cloud Development
- CI/CD
- Digital Transformation

Как DevOps и облако Azure образуют пригодную к эксплуатации платформу поставки
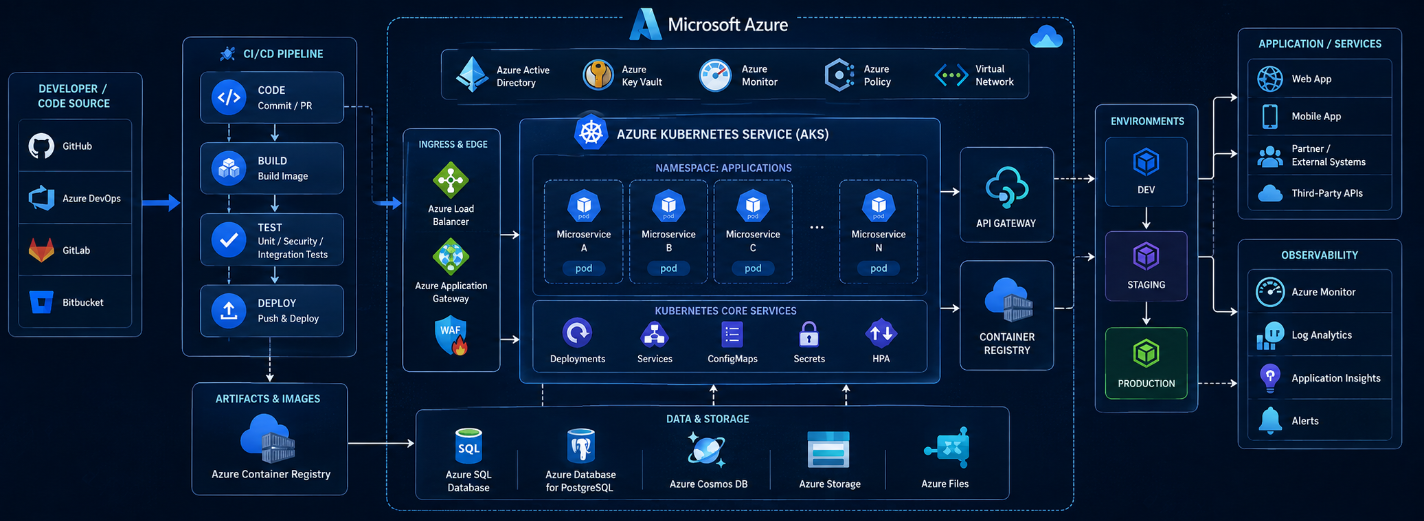
Azure предоставляет вычисления, данные, идентификацию, сеть, политики и средства наблюдения. DevOps определяет, как люди превращают эти возможности в повторяемые изменения продукта. Сочетание работает, когда команда может провести требование от хранилища кода до производственной среды, увидеть последствия, восстановиться после отказа и улучшить процесс без зависимости от недокументированных ручных знаний.
Поэтому DevOps — это эксплуатационная модель, а не сервер CI или отдел между разработкой и эксплуатацией. Специалисты по продукту, разработке, платформе, безопасности, поддержке и финансам работают в одной системе поставки с явными обязанностями. Разработчики отвечают за поведение в производственной среде; инженеры платформы дают поддерживаемые пути и предохранительные границы; безопасность формирует контроль и реагирование; владельцы продукта определяют результаты и риск; эксплуатация возвращает сведения о происшествиях и мощности в проектирование.
Начните с критических путей и нынешних ограничений. Измеряйте время от замысла до выпуска, частоту развёртываний, долю неудачных изменений, время восстановления, доступность, задержку, нагрузку от происшествий, рутинный ручной труд, удельную облачную стоимость и заблокированную работу. Нанесите на карту, как сейчас меняются код, инфраструктура, настройки, схемы, секретные ключи, политики и доступ к возможностям. Улучшайте узкое место, ограничивающее безопасную ценность для клиента, вместо установки всех модных средств.
Наши услуги облачной инженерии в Azure объединяют архитектуру нагрузки, автоматизацию поставки, наблюдаемость, надёжность, безопасность, стоимость и эксплуатационную ответственность в единой границе реализации.
Относитесь к инфраструктуре как к продукту и управляйте ею кодом
Инфраструктура как код описывает желаемое состояние ресурсов Azure в системе управления версиями, благодаря чему изменения можно проверять, испытывать, прослеживать и повторять. Включайте настройки ресурсов, удостоверения и назначения ролей, сети, диагностику, политики, оповещения и бюджеты, если выбранное средство способно безопасно ими управлять. Поддерживайте совместимость версий приложения и инфраструктуры и правильно упорядочивайте изменения, охватывающие обе стороны.
Применяйте декларативные средства вроде Bicep или управляемый процесс Terraform в соответствии со стандартами организации и потребностями нагрузки. Стройте модули вокруг устойчивых границ жизненного цикла, а не ради абстракции. Основы платформы, общая связность, ресурсы нагрузки, настройки уровня данных и выпуски приложения могут иметь разных владельцев и частоту изменений. Публикуйте поддерживаемые модули с версиями, документацией, проверками и путём обновления.
Разделяйте среды, их удостоверения, доступ, данные и радиус поражения, но создавайте их из одинаковых проверенных описаний. Различия параметров должны быть намеренными и видимыми. Заранее показывайте изменения, обнаруживайте разрушительные операции, защищайте состояние и устраняйте отклонения. Срочное исправление через портал может восстановить службу, однако его следует записать и вернуть в желаемое состояние, закреплённое в версиях.
Проверяйте обычные и исключительные операции: первое развёртывание, обновление, масштабирование, смену сертификата или секретного ключа, изменение политики, восстановление, переход в другой регион и удаление. IaC доказывает повторяемость лишь тогда, когда команда способна воссоздать или восстановить среду. Средства измерения и диагностические параметры должны входить в ту же версионируемую границу, которая описана в материале «Наблюдаемость Azure с OpenTelemetry».
Постройте надёжную цепочку поставки программного обеспечения
Конвейер поставки является границей безопасности и надёжности. Он должен создавать из проверенного кода один прослеживаемый неизменный компонент, записывать его версию и зависимости и продвигать именно этот компонент через все среды. Повторная сборка для производственной системы может внести непроверенное различие. Шаблоны инфраструктуры, переносы базы данных, контракты настроек и метаданные выпуска должны составлять одну историю изменения.
Подбирайте проверки по риску: компиляция и статический анализ, целевые модульные испытания, интеграционные и контрактные проверки, репетиция переноса, проверка инфраструктуры, поиск секретных данных, сканирование зависимостей и образов, контроль политик, происхождение и показательные испытания быстродействия или устойчивости. Каждому барьеру нужны владелец и способ реагирования; предупреждение, которое все игнорируют, лишь задерживает работу.
Когда это полезно, отделяйте развёртывание от открытия пользователям. Разверните небольшое изменение в предпроизводственной среде или кольце производственной системы, проверьте модель исправности, постепенно открывайте его через редакции, ячейки, маршрутизацию или управление возможностями и автоматически останавливайтесь при нарушении порога. Во время сосуществования версий нужна совместимость назад и вперёд. Изменения базы данных часто требуют последовательности «расширить — перенести — сузить», а не простого двоичного возврата.
До аварийного происшествия определите обычный, срочный, обратный, исправляющий и завершающий пути. Ограничьте круг тех, кто может менять конвейеры или согласовывать защищённые среды, сохраняйте доказательства для аудита и при поддержке используйте федерацию удостоверения нагрузки или другой краткосрочный механизм вместо долговечных ключей развёртывания. Самый быстрый конвейер — не тот, где меньше всего барьеров, а тот, который достаточно рано возвращает надёжные сведения для действия.
- Надёжное изменение: проверенный код, один прослеживаемый компонент, испытания и контроль безопасности по риску, версионируемые переносы, защищённые согласования, постепенное открытие и проверенное восстановление.
- Повторяемые среды: декларативная IaC, поддерживаемые модули, изолированные удостоверения и данные, видимые параметры, предварительный просмотр изменений, устранение отклонений, документированная ответственность и упражнения по восстановлению.
- Эксплуатационная обратная связь: телеметрия критических путей, модели исправности, оповещения с владельцами, инструкции, связь с развёртываниями, выводы из происшествий, пределы мощности, удельная стоимость и упорядоченный перечень улучшений.
Масштабируйте нагрузки без умножения эксплуатационного хаоса
Платформа должна делать безопасный путь легче импровизированного. Предлагайте поддерживаемые шаблоны, модули, компоненты конвейера, образцы идентификации, типовую телеметрию, создание сред, пояснения политик и документацию как продукт для пользователей. Опубликуйте границу: что эксплуатирует платформенная команда, за что отвечают команды нагрузок, как рассматриваются исключения и как отказаться от общей возможности.
Самообслуживание не означает неограниченное создание ресурсов. Установите предохранительные границы для подписок и групп ресурсов, регионов, сети, удостоверений, классов данных, меток, бюджетов, диагностики, резервных копий, открытого доступа и разрешённых служб. Давайте разработчикам быстрый отклик в запросах на внесение изменений и предпроизводственной среде, а не обнаруживайте нарушение политики, когда выпуск уже ожидает.
Масштабируйте нагрузки по измеренному спросу. Правилам автоматического масштабирования нужны сигналы, минимумы, максимумы, период охлаждения, время запуска, квоты и пределы стоимости. Защищайте базы данных, посредники сообщений, хранилища и внешних поставщиков ограничениями соединений и одновременности, очередями, противодавлением, предельным временем, безопасными повторными попытками и плавным ухудшением. Дополнительные копии способны усилить отказ зависимости.
Масштабируйте и эксплуатационную модель. Определите цели службы, пересмотр мощности, исправления, продления, восстановление резервных копий, дежурство при происшествиях, пересмотр доступа, обновление платформы, вывод модулей и подключение новых клиентов. Автоматизация оправдана, когда уменьшает повторяющийся риск или рутину; автоматизировать редкую и хорошо контролируемую задачу может быть дороже, чем документировать её.
Превратите телеметрию в более быстрое восстановление
Наблюдаемость начинается с решений, которые должна принимать команда. Определите критические пути и модель исправности, связывающую результат пользователя с сигналами приложения, зависимостей и инфраструктуры. Высокая доля успешных HTTP-ответов может скрывать работу в очереди, которая никогда не завершается; нормальный график CPU может сосуществовать с неудачными платежами. Измеряйте завершённые действия бизнеса, распределение задержек, ошибки, насыщение, возраст очередей, свежесть данных и поведение зависимостей.
Применяйте структурированные журналы, показатели и распределённые трассировки с согласованным контекстом службы, среды, версии, региона, безопасной отметки клиента, связи и причины. OpenTelemetry даёт переносимые средства измерения приложения, а Azure Monitor и Application Insights собирают и анализируют поддерживаемые сигналы. Контролируйте чувствительные данные, выборку, сроки хранения и метки с большим числом значений, чтобы наблюдаемость оставалась полезной и финансово устойчивой.
Оповещение должно указывать на состояние, требующее действия, доходить до ответственного, содержать контекст и ссылаться на проверенную инструкцию. Срочно сообщайте о заметных пользователю последствиях и неотложных причинах; менее важные тенденции направляйте в запланированные работы. Проверяйте оповещения во время упражнений с отказами. Панель, на которую никто не смотрит, и сигнал, на который никто не может отреагировать, — это имущество, а не эксплуатационная способность.
Для реагирования на происшествия нужны роли, связь, уровни важности, передача ответственности, полномочия уменьшить ущерб, сообщения клиентам, сохранение доказательств и проверка восстановления. Связывайте развёртывания с телеметрией, чтобы видеть влияние выпуска. После восстановления проведите разбор без поиска виноватых и улучшите код, проверки, контроль платформы, мощность, диагностику, инструкции или ответственность. Быстрое восстановление дают отработанные системы, а не личный героизм.
Встройте безопасность в каждый путь изменений
Безопасность должна охватывать каждый способ изменения платформы: исходный код, зависимости, компоненты, инфраструктуру, настройки, переносы данных, политики, управление возможностями и срочные операции. Постройте модели угроз для критических путей и самой системы поставки. Скомпрометированное удостоверение конвейера способно обойти средства, защищающие запущенное приложение.
Разделяйте удостоверения людей, конвейеров и программ во время работы. Для нагрузок Azure применяйте управляемые удостоверения, а для CI/CD при поддержке — федерацию удостоверения нагрузки или другой краткосрочный механизм. Предоставляйте узкие разрешения управления и доступа к данным в самой малой практической области, защищайте согласования сред, пересматривайте доступ и поддерживайте пригодный для аудита аварийный путь. Избегайте общих учётных данных и копирования ключей между средами.
Переносите полезный контроль ближе к началу, не превращая конвейер в груду предупреждений без действия. Проверяйте код и IaC, ищите секретные данные, сканируйте зависимости и образы, проверяйте политики и настройки, при необходимости — лицензии, сохраняйте происхождение компонентов. Определите уровень важности, владельца, срок исправления, окончание исключения и правила выпуска. Проверяйте контроль испытаниями на основе способов нападения и упражнениями с происшествиями.
Безопасность во время работы остаётся необходимой: поддерживаемые версии, исправления, открытая сеть, шифрование, проверка ввода, авторизация, секретные данные, резервные копии, наблюдение, реагирование и восстановление. Azure Policy и барьеры конвейера могут обеспечивать известные правила, но не способны определить модель доверия продукта или права бизнеса. Команда безопасности должна предоставлять готовые средства и быстрые консультации, а не создавать очередь поздних согласований.
Свяжите облачные расходы с решениями о продукте
Облачными расходами можно управлять, когда у каждого ресурса есть владелец, назначение, среда, нагрузка и жизненный цикл. До роста счетов установите границы подписок и групп ресурсов, метки или равноценные метаданные, бюджеты, оповещения об отклонениях и доступ к сведениям о стоимости. Команды должны отвечать за цену решений, на которые влияют, а платформа и финансы — давать надёжное распределение и рекомендации.
Связывайте стоимость с единицами продукта: активным клиентом, успешным заказом, обработанным документом, пользователем API, развёртыванием или часом испытательной среды. Более крупный счёт может быть здоровым признаком роста ценного спроса, а меньший — вредить, если убирает мощность восстановления или полезную телеметрию. Рассматривайте стоимость вместе с целями службы, быстродействием, безопасностью и инженерной рутиной.
Автоматизируйте безопасную уборку: удаляйте временные среды после срока, планируйте работу подходящих непроизводственных ресурсов, обеспечивайте сроки хранения, находите бездействующие или неиспользуемые ресурсы, подбирайте размер по телеметрии, ограничивайте масштабирование и показывайте изменения прогноза при архитектурной проверке или просмотре кода. Оптимизируйте запросы приложения, жизненный цикл хранилища, передачу данных, объём журналов и использование зависимостей, прежде чем считать более дешёвый SKU универсальным ответом.
Скидки за обязательства и резервирование уместны для устойчивого, понятного спроса. Копии для надёжности, резервные данные, контроль безопасности, агенты сборки, наблюдаемость и упражнения по восстановлению не являются расточительством лишь потому, что не обслуживают обычный поток пользователей. Сравнивайте их цену с последствиями, которые они уменьшают. FinOps — это общий цикл решений продукта, разработки, платформы и финансов.
Azure предоставляет облачные возможности. DevOps превращает их в систему поставки и эксплуатации, в которой команда понимает и улучшает изменения, риски, результаты, восстановление и расходы.— GARNO.TECH
Платформа успешна, когда команды умеют её эксплуатировать
Azure и DevOps дают преимущество, когда платформа уменьшает стоимость и риск содержательного изменения продукта. Инфраструктуру можно воспроизвести, компоненты — проследить, выпуски малы и открываются постепенно, удостоверения ограничены, телеметрия объясняет поведение клиента, восстановление отработано, а у расходов есть владелец. Эти свойства важнее числа служб или этапов конвейера.
Внедряйте эксплуатационную модель постепенно. Проверяйте изменения кода приложения и инфраструктуры; постройте один надёжный путь компонента; защитите критический путь моделью исправности; автоматизируйте его выпуск и восстановление; затем повторно используйте проверенный образец. Добавляйте платформенные абстракции лишь тогда, когда у нескольких команд одинаковая потребность и кто-то будет поддерживать контракт.
Измеряйте, улучшает ли система время поставки, долю неудачных изменений, восстановление, надёжность, рутину, реагирование на безопасность, опыт разработчика и удельную стоимость. Удаляйте барьеры, панели, модули и автоматизацию, которые не помогают принимать решения. Современная платформа не завершается в день запуска: она учится на развёртываниях, происшествиях, пользователях и расходах и превращает эти сведения в следующее более безопасное изменение.
steps:
- script: npm ci
- script: npm test
- script: az deployment group create --template-file main.bicepСтоит ли команде строить сложную платформу Azure до того, как её потребует рост продукта?
Наши исследования
Исследование и разработка решений на основе искусственного интеллекта для оптимизации бизнес-процессов и повышения эффективности принятия решений.
Анализ моделей машинного обучения для прогнозной аналитики в сфере финансов, электронной коммерции и SaaS-платформ.
Исследование технологий обработки естественного языка и компьютерного зрения для усиления автоматизации, персонализации и поддержки клиентов.