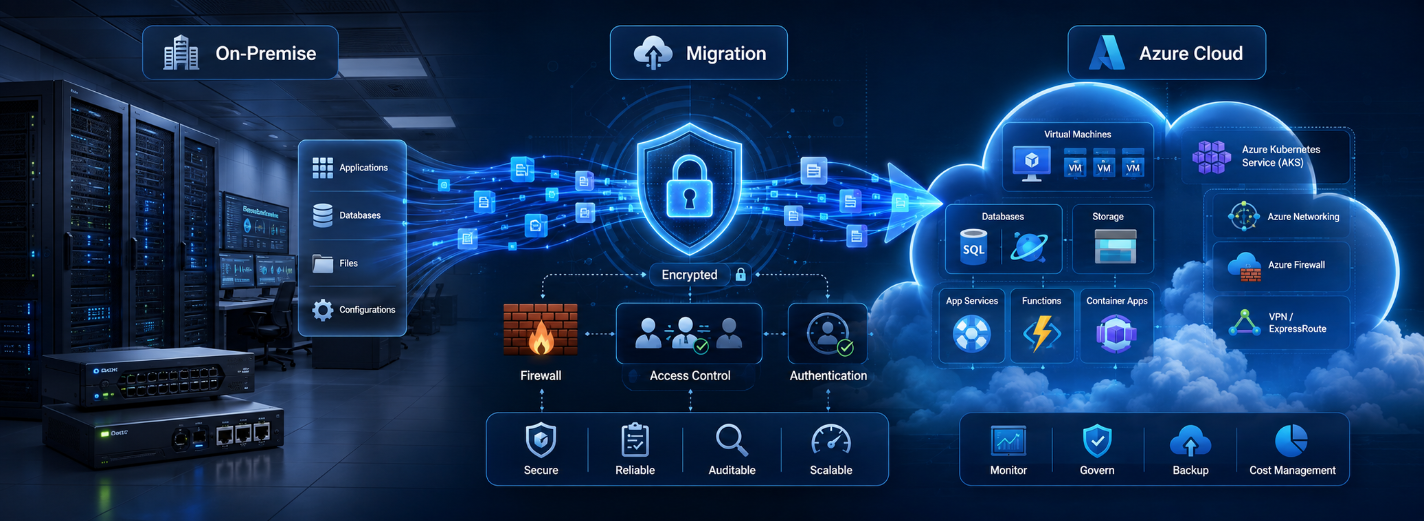
Архитектура миграции в Azure: от существующих систем к управляемому облаку
- Microsoft Azure
- cloud migration
- cloud architecture
- cybersecurity
- DevOps
- infrastructure modernization
Как спланировать безопасный переход в облако Azure
Миграция в Azure изменяет систему, на которой работает бизнес, а не просто переносит серверы. Приложения, данные, цифровые идентичности, сети, интеграции, процессы поддержки и договорные обязательства должны действовать непрерывно, пока ответственность переходит между технологиями и командами. Обоснованная архитектура миграции в Azure описывает и целевую платформу, и сам переход: что будет перенесено, что изменится, что останется на месте, как будут сосуществовать среды и как организация вернётся в безопасное состояние, если предположение окажется ошибочным.
Сначала определите результат, ради которого нужен переход. Это может быть закрытие старого центра обработки данных, более надёжное восстановление, быстрый выход на новый рынок, регуляторное разделение, интеграция приобретённой компании, потребность в большей мощности или снижение стоимости изменений. Для каждого результата установите исходный уровень, цель, ответственного, срок и защитные ограничения. «Перейти в Azure» — лишь действие; оно не объясняет руководящему комитету, действительно ли сократились простои, риск, время поставки изменений и совокупные затраты и улучшился ли опыт клиента.
Миграция завершается лишь тогда, когда принимающие систему команды могут развёртывать и наблюдать нагрузки, защищать и восстанавливать их, предоставлять поддержку и управлять затратами. Поэтому компетентная инженерная команда Microsoft Azure должна провести согласованный замысел через описание инфраструктуры кодом, изменения приложений и данных, репетиции, переключение рабочей системы, стабилизацию, документирование и передачу знаний.
Изучите существующие системы до выбора сервисов Azure
Инвентаризируйте существующие системы с детализацией, достаточной для решения о переключении. Зафиксируйте функции бизнеса и ответственных за них; приложения и версии; вычислительные ресурсы, хранилища и базы данных; входящие и исходящие сетевые пути; пользовательские, служебные и административные цифровые идентичности; сертификаты, секреты, расписания, очереди, файлы, отчёты и внешних участников. Объедините данные конфигурации и автоматического обнаружения с интервью, сведениями о трафике, инцидентах и счетах, историей развёртываний и наблюдением за полным циклом работы бизнеса. Схема, в которой нет задания на конец месяца или списка разрешённых адресов партнёра, не является картой миграции.
Классифицируйте каждую нагрузку по критическим пользовательским путям, чувствительности и месту хранения данных, доступности, целевому времени и точке восстановления, задержке, пропускной способности, сезонности, лицензиям, поддержке поставщика, техническому состоянию, частоте изменений и ответственному владельцу. Для каждой зависимости опишите направление, протокол, аутентификацию, объём данных, время взаимодействия и поведение при отказе. Такие факты выявят группы, которые следует переносить вместе, временные гибридные пути, неподдерживаемые компоненты, средства контроля, требующие замены, а также системы, которые лучше оставить или вывести из эксплуатации вместо переноса.
До начала изменений зафиксируйте исходное состояние: успешность пользовательских сценариев, процентили быстродействия, частоту ошибок и инцидентов, показатели развёртывания и восстановления, доступную мощность, нагрузку на поддержку, стоимость инфраструктуры и лицензий и имеющиеся доказательства восстанавливаемости. Открыто обозначьте уровень уверенности и пробелы. Если существующие системы изучены плохо, добавьте измерения и проверьте показательный период вместо выдуманной точности. Эти границы также определяют архитектуру безопасности Azure для FinTech и SaaS, в которой цифровые идентичности, ключи, изоляция сетей, возможность аудита и расположение данных должны оставаться согласованными между старой и новой средами.
- Опишите систему в работе: свяжите бизнес-пути с приложениями, данными, сетями, цифровыми идентичностями, расписаниями, внешними участниками, ответственными и поведением каждой зависимости при отказе.
- Классифицируйте последствия: зафиксируйте критичность, чувствительность и место хранения данных, доступность, целевое время и точку восстановления, допустимый простой, требования соответствия и влияние на клиентов.
- Определите исходную экономику: учтите вычислительные ресурсы, хранилища, трафик, лицензии, помещения, поддержку, труд людей, параллельные затраты во время миграции, модернизацию и вывод из эксплуатации, а не только расчёт стоимости облака.
- Установите доказательства и ответственность: назначьте ответственных от бизнеса и технической команды, определите доказательства приёмки и восстановления, нерешённые предположения и решение, которому должна помочь каждая находка.
Спроектируйте базовую среду Azure как основу эксплуатации
Базовая облачная среда является управляемой основой, на которой можно последовательно размещать нагрузки. Определите границы организации и цифровых идентичностей, группы управления, подписки, структуру ресурсов, разрешённые регионы, правила именования и метки, политики, назначение ролей, бюджеты, централизованные журналы, сетевые соединения, частное разрешение имён, общие сервисы, резервное копирование, восстановление и путь от кода до рабочей среды. Отделите общеплатформенные средства контроля от настроек конкретных нагрузок и опишите оба слоя как проверяемую инфраструктуру в коде с защищённым состоянием, испытанными модулями, историей изменений, выявлением расхождений и аварийным путём, изменения из которого впоследствии возвращают в код.
Топология подписок и сети должна соответствовать требованиям к изоляции, ответственности, квотам, учёту затрат и последствиям отказов. Осознанно спроектируйте входящий и исходящий трафик: публичный доступ, частные конечные точки, межсетевые экраны, защита веб-приложений, DNS, маршрутизация, проверка трафика, соединения с партнёрами и локальной инфраструктурой и аварийный доступ должны образовывать единый пригодный для испытания путь. Избегайте как единой плоской сети, так и сложного разделения на сегменты, которое команда не способна эксплуатировать. Заранее решите, как будете наблюдать за временными гибридными соединениями и как их удалите.
Управление должно предотвращать дорогостоящие или опасные состояния, не блокируя каждое полезное изменение. Применяйте небольшой набор обязательных правил для регионов, шифрования, публичного доступа, диагностических настроек, цифровых идентичностей, типов ресурсов и необходимых метаданных; испытывайте исключения, назначайте для них ответственного и срок действия и фиксируйте причину. Базовая среда готова тогда, когда продуктовая команда может создать соответствующую правилам среду, понимает свою ответственность и способна её восстановить, а не тогда, когда скопирована образцовая схема.
Выбирайте сервисы Azure на основании фактов о нагрузке и способности команды их эксплуатировать. Стабильная готовая система может лучше всего работать на виртуальной машине. Веб-приложению может подойти Azure App Service, событийным задачам — Azure Functions, базе данных — управляемый сервис, а контейнерам — Azure Container Apps или Kubernetes, но лишь если требования к планированию, сети, переносимости или контролю оправдывают такую платформу. Сравнивайте соответствие функциям, ограничения сервиса, модель доступности, обслуживание, наблюдаемость, безопасность, поддержку регионов, переносимость, имеющиеся навыки и полную стоимость жизненного цикла.
Управляемый сервис не означает управляемого результата. Задокументируйте, какие обязанности по устойчивости, обновлениям, резервному копированию, масштабированию, управлению ключами, доступу, согласованности данных и восстановлению берёт на себя Microsoft, а какие остаются у организации. Проверьте квоты и ограничения интенсивности запросов при показательном трафике, в том числе во время отказа зависимости. Отдавайте предпочтение самому простому сервису, который удовлетворяет существенные требования и сохраняет путь выхода или восстановления. Сложность оправдывают доказательства, а не количество облачных продуктов на целевой схеме.
Защищайте цифровые идентичности и данные в каждой волне миграции
Безопасность начинается с цифровых идентичностей и границ доверия. Объедините доступ сотрудников через единую систему, а для привилегированных ролей, где возможно, требуйте устойчивой к фишингу усиленной аутентификации. Предоставляйте повышенные права только на необходимое время, разделяйте обычные и административные учётные записи и поддерживайте проверенные аварийные записи. Предоставляйте нагрузкам управляемые идентичности вместо встроенных учётных данных. Назначайте минимальные права в самых узких практических границах, проверяйте наследование и состав групп, регистрируйте привилегированные действия и до переключения спроектируйте отзыв доступа.
Классифицируйте данные и прослеживайте их путь через источник, канал переноса, промежуточное и целевое хранилища, резервные копии, журналы, кеши, аналитику и средства поддержки. Определите правила шифрования и владельца ключей, смену секретов, сроки хранения и удаления, маскирование, место расположения, сверку целостности и доказательства доступа. Защитите каналы миграции и временные хранилища, а после приёмки удалите их. Резервная копия остаётся лишь обещанием, пока команда не восстановит её за требуемое время, не проверит согласованность приложения и не докажет, что учётные данные с разрушительными правами не способны стереть и сервис, и копии для его восстановления.
Встройте в платформу предотвращение и обнаружение: принудительное выполнение политик, безопасные типовые настройки, управление уязвимостями и зависимостями, защиту конечных устройств там, где она нужна, централизованные журналы безопасности, действенные оповещения, порядок реагирования на инциденты и хранение доказательств. Отдельно смоделируйте угрозы самого перехода. Гибридные соединения, дублирующиеся идентичности, миграционные учётные записи с широкими правами, старые сертификаты, копии данных и поспешные правила межсетевых экранов часто создают больше уязвимостей, чем окончательное решение. Для каждого временного исключения нужны назначенный ответственный, наблюдение, срок завершения и проверка удаления.
Безопасная миграция в Azure начинается с определения доверия, ответственности и восстановления. Копирование первой виртуальной машины является шагом исполнения, а не архитектурой.— GARNO.TECH Engineering Team
Подбирайте способ переноса отдельно для каждой нагрузки
Для каждой нагрузки отдельно определите способ действий, вместо того чтобы применять один лозунг ко всем системам. Выводите из эксплуатации решения без обоснованной ценности; оставляйте на месте нагрузки, ограничения или экономика которых не поддерживают переезд; заменяйте типовую функцию готовым продуктом, если миграция лишь сохранит ненужный собственный код. Перенос без изменений сокращает ближайшую работу по переходу, но наследует существующие операционные недостатки. Перемещение совместимой платформы почти не меняет приложение. Адаптация к новой платформе задействует выбранные управляемые возможности. Переработка архитектуры меняет границы или поведение и может улучшить гибкость и устойчивость, однако создаёт наибольший риск поставки.
Оценивайте варианты по ожидаемому результату миграции, сроку, техническому состоянию, зависимостям, привязанности к данным, допустимому простою, требованиям соответствия, навыкам команды, условиям лицензий, будущей стоимости эксплуатации, ценности модернизации, обратимости и стоимости упущенных возможностей. Оставляйте предположения видимыми и назначайте критерии приёмки. Для одной нагрузки можно применить последовательность действий: например, сначала перенести её без изменений до закрытия центра обработки данных, стабилизировать, а после появления доказательств адаптировать базу данных к управляемой платформе. Не скрывайте две рискованные трансформации в одном переключении, если сочетание не является необходимым и его нельзя отрепетировать.
Модернизируйте там, где это устраняет измеренное ограничение. Полезными изменениями могут быть воспроизводимое развёртывание, неизменяемые артефакты, вынесенная из кода конфигурация, управляемые идентичности, централизованная телеметрия, поддерживаемые среды выполнения, управляемые базы данных, очереди, кеширование, асинхронные границы, горизонтальное масштабирование и совместимое развитие схемы данных. Каждому изменению нужны бизнес- или операционная гипотеза, ответственный, испытание и путь восстановления. Масштабная программа перехода к микросервисам или Kubernetes не является предпосылкой миграции.
Относитесь к переносу данных как к изменению продукта. Выбирайте массовое копирование, резервное копирование с восстановлением, репликацию, параллельную работу систем, фиксацию изменений данных или поэтапную синхронизацию в соответствии с объёмом, скоростью записи, допустимой потерей, простоем, требованиями согласованности и возможностями источника. На каждом этапе определите главный источник данных; предотвращайте противоречащие друг другу записи; отрепетируйте длительность; сверьте количество записей, контрольные суммы, балансы, связи и неизменные правила бизнеса; сохраните пригодное для аудита решение об окончательном переключении. Если возврат к старой системе потеряет уже принятые записи, честно назовите это планом исправления в новой системе и спроектируйте соответствующий путь.
Подтверждайте готовность, переносите и стабилизируйте управляемыми волнами
До переноса самых критичных систем проверьте весь механизм миграции на показательной нагрузке, которую можно безопасно восстановить. Пробный переход должен испытать настоящие цифровые идентичности, сетевые соединения, инфраструктуру в коде, развёртывание, перенос данных, наблюдаемость, резервное копирование и восстановление, реагирование на угрозы, быстродействие, поддержку и распределение затрат. Выберите систему, достаточно важную для выявления пробелов платформы, но с такими границами, чтобы восстановление не нанесло неприемлемого ущерба. Фиксируйте каждое ручное вмешательство: потребность всякий раз в героических усилиях является недостатком метода миграции.
Формируйте последующие волны вокруг групп зависимостей и доступной операционной способности. Для каждой волны назначьте ответственных от бизнеса и технической команды, определите объём и исключения, предпосылки, правила замораживания изменений, окно обслуживания, порядок информирования, критерии приёмки и остановки, сверку данных, возврат к старой системе или исправление без возврата, обеспечение поддержки и ограниченный срок стабилизации. Репетируйте на объёме и отказах, подобных рабочим. Убедитесь, что DNS, сертификаты, очереди, запланированные задания, интеграции, наблюдение и доступ пользователей меняются согласованно, а не ограничивайте проверку начальной страницей приложения.
Сделайте переключение контролируемым решением. Используйте общее расписание, явно назначенное право продолжить или отменить переход, наблюдаемые контрольные точки и доказательства, которые все участники толкуют одинаково. После направления трафика следите за критическими путями, целостностью данных, задержкой, насыщением ресурсов, ошибками, сигналами безопасности, спросом на поддержку и затратами в разрезе среды и версии. Сохраняйте старый путь лишь на протяжении согласованного периода восстановления, ограничьте изменения и выведите его из эксплуатации по проверенному плану, чтобы временное дублирование не стало постоянным риском и расходом.
Стабилизация завершается, когда сервис достигает своих целей, а принявшая его команда способна эксплуатировать систему в обычных и исключительных условиях. Передайте панели наблюдения, оповещения, операционные инструкции, описания архитектуры и принятых решений, перечни ресурсов, маршруты поддержки и передачи проблем на более высокий уровень, процедуры доступа, результаты восстановления, известные риски, бюджеты и ответственность. Проведите учение по реагированию на инцидент и восстановление с измерением времени. Закрывайте временные учётные записи, маршруты, копии данных, исключения, лицензии и исходную инфраструктуру лишь после доказательств того, что они больше не нужны.
Измеряйте фактические затраты Azure по нагрузке, среде, ответственному и полезной операции. Исследуйте неиспользуемые ресурсы, избыточную мощность, дорогие уровни сервиса без обоснования, неприсоединённые хранилища, чрезмерное журналирование, слишком долгие сроки хранения, межрегиональную или исходящую передачу данных, покрытие резервированиями и расписания нерабочих сред. Оптимизируйте с учётом целей сервиса и времени инженеров, а не ради самого низкого месячного счёта. Через 30, 60 и 90 дней пересмотрите исходные цели миграции; превратите пробелы в усовершенствования с назначенными ответственными, вместо того чтобы объявлять успех в день переключения.
Оценивайте миграцию по готовности системы к эксплуатации
Надёжная архитектура миграции в Azure связывает намерение бизнеса, факты о существующих системах, управление платформой, проектирование нагрузок, цифровые идентичности, данные, восстановление, затраты и операционную ответственность. Она снижает риск, превращая предположения в утверждения, которые можно проверить, и проводя ограниченные группы зависимостей через отрепетированный путь.
Устойчивым результатом является не подписка Azure, заполненная ресурсами, а платформа и команда, которые могут безопасно выпускать изменения, видеть влияние на пользователей, выдерживать отказы, восстанавливать данные, контролировать доступ и затраты и совершенствовать систему после завершения программы миграции. Оценивайте каждое архитектурное решение по тому, усиливает ли оно эту способность.
Четыре этапа перехода в Azure под управлением доказательств
- /01Нанесите на карту зависимости, цели и рискиИнвентаризируйте работающие системы, проследите критические пути, определите исходные показатели быстродействия, восстановления и затрат, выявите неизвестное и сгруппируйте зависимости до выбора сервисов и волн.
- /02Создайте и докажите надёжность базовой средыРеализуйте цифровые идентичности, подписки, сетевые пути, политики, журналирование, бюджеты, резервное копирование, восстановление и развёртывание как проверяемую инфраструктуру в коде; испытайте средства контроля и исключения на показательной нагрузке.
- /03Выполните переход ограниченной группы зависимостейОтрепетируйте перенос данных и переключение на объёмах, подобных рабочим, с чёткими полномочиями, критериями приёмки и остановки, сверкой, информированием, возвратом или исправлением без возврата и обеспеченной специалистами стабилизацией.
- /04Проверьте эксплуатацию и закройте старый путьПодтвердите цели сервиса, доказательства безопасности, восстановление за измеренное время, готовность поддержки, ответственность и фактические затраты; затем закройте временный доступ, исключения, копии данных, соединения, лицензии и исходную инфраструктуру.
Стоит ли переносить все нагрузки в Azure одной волной?
Стоит ли переносить все нагрузки в Azure одной волной?
Спланируйте переход в Azure для устойчивой эксплуатации
Предоставьте сведения о предельном сроке, установленном бизнесом, существующих системах и зависимостях, критических путях, границах данных и нормативных требований, текущей готовности к восстановлению, целевых результатах, способности команды, бюджете и известных ограничениях. GARNO.TECH поможет определить минимально достаточную оценку, архитектуру базовой среды, способ действий для каждой нагрузки, волны миграции, средства защиты и контроля данных, приёмку, восстановление, стабилизацию, вывод старых систем из эксплуатации и передачу знаний.
Публикации
Наши исследования
Исследование и разработка решений на основе искусственного интеллекта для оптимизации бизнес-процессов и повышения эффективности принятия решений.
Анализ моделей машинного обучения для прогнозной аналитики в сфере финансов, электронной коммерции и SaaS-платформ.
Исследование технологий обработки естественного языка и компьютерного зрения для усиления автоматизации, персонализации и поддержки клиентов.
Миграция базы данных в Azure: оценка, переключение и возврат
Спланируйте миграцию базы данных в Azure: оцените нагрузку, выберите цель, устраните несовместимости, перенесите и проверьте данные, выполните переключение, возврат и оптимизацию.
10 мин чтения
10 Sep 2026
Как спланировать серверную часть на NestJS: границы, архитектура и реализация
Практическое руководство по планированию серверной части на NestJS вокруг деловых возможностей, договоров API, ответственности за данные, безопасности, взаимодействия с системами, фоновой работы, эксплуатации и измеримых этапов.
8 мин чтения
05 Aug 2026
Azure App Service, Container Apps или AKS: выбор по модели ответственности
Сравнение Azure App Service, Container Apps и AKS по типу нагрузки, эксплуатационной ответственности, масштабированию, сети, изоляции, выпускам, восстановлению, наблюдаемости и полной стоимости владения.
9 мин чтения
08 Sep 2026