Главная Наши услуги
Масштабирование программного продукта: мощность без лишней сложности

Масштабирование программного продукта: мощность без лишней сложности

Масштабирование программного продукта: мощность без лишней сложности

Масштабируйте растущую платформу SaaS, FinTech или бизнес-систему: измеряйте настоящее ограничение, защищайте рабочую систему, улучшайте весь путь пользователя и проверяйте каждое изменение относительно исходных показателей.

Измеренные ограничения · постепенные изменения · безопасность рабочей системы · подтвержденная мощность

Программному продукту редко нужно «масштабироваться» везде одновременно. Один путь клиента замедляется с ростом данных; синхронная зависимость удерживает открытым каждый запрос; блокировки базы данных заставляют работу выполняться последовательно; очередь слишком долго оправляется после всплеска; выпуски становятся ограничением из-за неясной ответственности и порядка возврата изменений. Дополнительные ресурсы могут ненадолго скрыть признак, одновременно увеличивая расходы и сложность эксплуатации. Полная перестройка архитектуры способна лишь передвинуть узкое место, не улучшив результат.

Мы рассматриваем масштабирование как задачу продукта и его эксплуатации. Работа начинается со спроса бизнеса, опыта пользователей, фактов из рабочей системы и последствий отказа. Она связывает браузер, API, данные, отложенную обработку, внешние службы, облачные ресурсы, поставку и ответственность команды. У каждого изменения есть предположение, измеримые условия приемки, безопасный порядок внедрения и путь восстановления. Мощности можно доверять, когда продукт достигает цели при определенной нагрузке, а затем возвращается в исправное состояние.

Полезный вопрос звучит не «Насколько большой может стать эта архитектура?», а «Какой спрос продукт должен обслуживать, к какому сроку, с каким удобством, надежностью и себестоимостью одной операции и как это будет доказано?». Такая формулировка не позволяет умозрительным платформенным замыслам отнять время, необходимое для устранения сегодняшнего ограничения.

Признаки того, что продукт перерос действующую систему
/ 01
С ростом спроса критические пути теряют качество
Пользователи сталкиваются с более долгими задержками для самых медленных операций, истечением времени ожидания, устаревшим состоянием или прерыванием пути с ростом трафика, данных, сложности клиентов, работы интерфейса или числа вызовов API.
/ 02
Каждый выпуск и каждая авария несут больше риска
Небольшие изменения вызывают ухудшение, проблемы обнаруживаются поздно, восстановление зависит от отдельных людей, а команды избегают выпусков именно тогда, когда обучение продукта важнее всего.
/ 03
Данные и фоновые задачи перестают восстанавливаться
Запросы, блокировки, запасы соединений, очереди, плановые задачи или внешние службы накапливают задержку, умножают повторы и не возвращаются в исправное состояние после завершения пика трафика.
/ 04
Расходы и координация растут быстрее ценности
Расходы на облако, передачи работы, дублированные службы, пробелы ответственности и операционная нагрузка растут, а результат для клиентов и скорость безопасной поставки не меняются.

Устраняйте ограничение на всем пути продукта

Проследите критический путь от действия пользователя до надежно сохраненного результата. Работа с интерфейсом может уменьшить объем JavaScript, задержку отрисовки, цепочки последовательных сетевых запросов и лишние обращения к API. На сервере можно устранить повторные вычисления, ограничить одновременность, согласовать время ожидания, сделать повторные запросы безопасными, перенести длительную работу в очередь или упростить наиболее нагруженный путь. Для данных это может быть изменение индекса, запроса, границы операции, способа доступа, правил временного хранения, распределения, архивирования или согласования. Для инфраструктуры — подбор нужной мощности, лучшие сигналы масштабирования, предварительный прогрев, пределы соединений, размещение по регионам, хранение на границе сети, управление входящей нагрузкой и контролируемое сокращение возможностей при отказе.

Тот же путь зависит от наблюдения, надежности выпусков и ответственности. Быстрая конечная точка не поможет, если пользователь видит устаревшие данные, очередь незаметно теряет работу или причину аварии невозможно установить. В соответствии с риском мы добавляем трассировку, проверки деловых операций, цели службы, доказательства работы под нагрузкой и при отказе, управление развертыванием, возврат изменений, операционные инструкции и готовность дежурной команды. Цель — наименьшее согласованное изменение, которое улучшает ограниченный результат и не перекладывает скрытые расходы на поддержку, безопасность или другую команду.

Опирайтесь на фактическое состояние рабочей системы и модель будущего спроса

Сначала определите деловое событие: прогнозируемый трафик запуска, нового крупного клиента, более быстрый рост данных, выход в другой регион, более строгие обязательства по доступности или череду аварий, которые уже стоят выручки и доверия. Зафиксируйте критические пути, объем и форму спроса, число уникальных значений и рост данных, географическое распределение, отношение пиковой и средней нагрузки, сезонные события, зависимости, цели службы, ожидания от восстановления, предельную стоимость и срок готовности необходимой мощности. Различайте среднюю нагрузку, всплеск, длительный максимум, накопленную очередь и условия отказа и восстановления.

Зафиксируйте исходное состояние по свидетельствам пользователей и системы: задержке по процентилям, пропускной способности, ошибкам, незавершенным действиям пользователей, времени ожидания в очереди, поведению базы данных, насыщению ресурсов, доле попаданий во временное хранилище, вызовам зависимостей, частоте развертываний, неудачным изменениям, продолжительности аварий, расходам на облако и себестоимости полезной операции. При необходимости разделяйте данные по пути, клиенту, региону, устройству, объему данных и версии. До выводов проверьте качество телеметрии. Если причина, риск или приоритет остаются непонятными, целевой аудит продукта поможет построить модель решения, но полный аудит излишен, когда ограничение и доказательства уже ясны.
Стройте план масштабирования вокруг измеримых решений

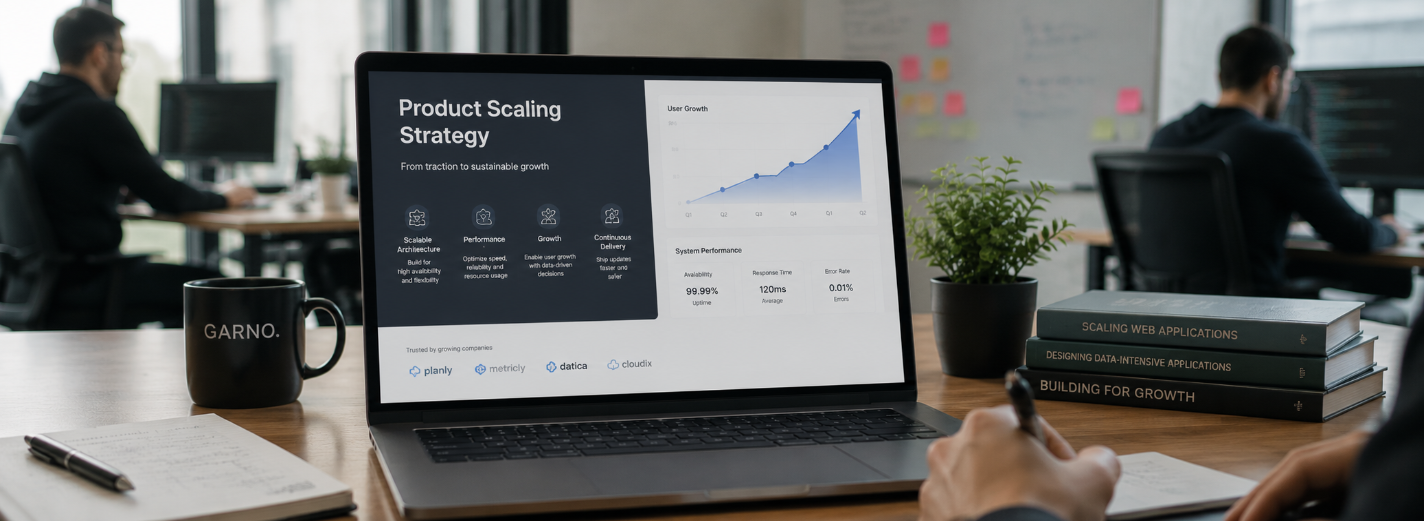
Разделите план на немедленную защиту, точечное улучшение, структурные изменения и управление мощностью. Немедленная защита может включать ограничение частоты, пределы очереди, время ожидания, средства отсечения неисправных зависимостей, отклонение избыточной нагрузки, переключатели возможностей, управление трафиком, оповещения и проверенное восстановление. Точечное улучшение устраняет измеренное узкое место. Структурное изменение затрагивает границу, модель данных или способ исполнения лишь тогда, когда меньшие вмешательства не достигают цели. Управление мощностью превращает ожидаемый спрос, безопасную загрузку и время наращивания ресурсов в прогноз с назначенными ответственными.

Для каждой инициативы запишите исходные показатели, причинное предположение, ожидаемое влияние, затронутый путь, зависимости, стоимость, риск, показатель приемки, способ проверки, порядок внедрения, период наблюдения, условия возврата или исправления следующим изменением и ответственного. Определяйте приоритет по влиянию на пользователей и выручку, снижению риска, цене задержки и надежности доказательств. Выпускайте постепенно, сравнивайте поведение рабочей системы с исходным состоянием и оставляйте лишь изменения, которые улучшают весь результат. Более быстрый API, который удваивает облачные расходы, ухудшает надежность или переносит ожидание в очередь, требует явного компромисса, а не автоматической отметки успеха.

Применяйте опыт сложных продуктов без недоказанных утверждений

Подходящий опыт помогает команде распознавать типичные формы отказов, задавать более точные вопросы и безопаснее готовить перенос. Результаты одного продукта не дают оснований обещать другому такие же задержку, пропускную способность или стоимость. Приведенные ниже примеры показывают работу с продуктами, где есть много ролей, операционными процессами, интеграциями, интерфейсами с большим объемом данных и поставкой в облаке. Их ценность состоит в рассмотренных инженерных и продуктовых границах; мы не приписываем им непроверенных результатов быстродействия или масштабирования.

Для новой работы доказательства должны происходить из действующей системы: ее кода и архитектуры, нагрузки, телеметрии, данных, сред, аварий, ограничений поставки и команды эксплуатации. Мы разделяем наблюдаемое, выведенное из фактов и то, что еще требует эксперимента. Так пример предыдущей работы не подменяет диагностику, а заинтересованные стороны получают вывод, который можно обосновать при архитектурном, финансовом и операционном рассмотрении.

Подбирайте технологию под измеренное узкое место

Решением может стать улучшение быстродействия и модернизация Angular, архитектура серверной части на NestJS, работа с базой данных и очередями, мощность и надежность Azure или целевое нагрузочное тестирование. Так же достаточными могут быть изменение настроек, удаление ненужной возможности, ограниченное пакетное задание, более удачный запрос, меньший объем передаваемых данных, правила трафика, временное хранилище, более ясная ответственность или отказ от лишней службы. Технология должна следовать из измеренного ограничения и возможностей команды, которая будет эксплуатировать результат.

Мы добавляем микрослужбы, Kubernetes, событийные границы, архитектуру в нескольких регионах или новую инфраструктуру данных лишь тогда, когда это оправдывают нагрузка, изоляция, развертывание, восстановление, соблюдение требований или распределение ответственности в команде. До внедрения нового компонента определите способы отказа, модель согласованности, наблюдение, безопасность, перенос, возврат, потребность в людях и путь отказа от решения. Хорошо построенное модульное приложение на управляемой платформе способно масштабироваться значительно дальше ранних ожиданий; за сложность стоит платить лишь при наличии доказательств.

Выберите формат сотрудничества в соответствии с ограничением

Целевая работа с узким местом: найти и устранить одно измеримое ограничение, например задержку оформления заказа, восстановление очереди, борьбу за ресурс в базе данных, время загрузки интерфейса или надежность выпусков. Формат подходит ясной проблеме с доступными доказательствами и ограниченным путем проверки.

Поэтапная модернизация: последовательно поставлять совместимые архитектурные и операционные изменения, когда ограничение пересекает несколько границ. План защищает рабочую систему, отделяет обязательные предпосылки от необязательных изменений, включает перенос и возврат и дает полезные результаты до завершающего этапа.

Постоянная команда масштабирования: непрерывно предоставлять компетенции по продукту, архитектуре, быстродействию, платформе и качеству по мере развития использования и объема продукта. Команда работает в одном упорядоченном перечне задач и системе поставки, поддерживает модель мощности, передает знания и меняет состав вместе с ограничением. В каждом формате заказчик сохраняет приоритеты продукта, учетные записи, данные, код, полномочия в рабочей системе и долгосрочный контроль.

Как масштабировать продукт на основе доказательств
  1. /01
    Определите спрос и измерьте исходное состояние
    Опишите деловое событие, критические пути, модель нагрузки и ожидания от восстановления; проверьте телеметрию и соберите сведения о пользователях, приложении, данных, инфраструктуре, поставке и расходах до выбора решения.
  2. /02
    Найдите главное ограничение и определите его приоритет
    Сопоставьте сигналы на всем пути, по возможности воспроизведите условие, проверьте причинные предположения и упорядочьте работу по влиянию на клиентов и выручку, риску, цене задержки и уверенности в доказательствах.
  3. /03
    Меняйте постепенно и проверяйте безопасно
    Защитите рабочую систему, выпустите ограниченное совместимое изменение с достаточным наблюдением, испытайте его при нагрузке, близкой к реальной, проследите восстановление и применяйте четкие условия остановки, возврата или исправления следующим изменением.
  4. /04
    Сравните результат и обновите модель мощности
    Сравните с исходным состоянием сведения о пользователях, надежности, пропускной способности, ресурсах и расходах; оставьте полезные изменения, зафиксируйте следующее узкое место и пересматривайте прогноз мощности вместе с изменениями спроса и архитектуры.
Сначала найдите ограничение, которое сегодня сдерживает продукт

Покажите критический путь, имеющиеся доказательства, ожидаемый спрос, архитектуру, аварии и последствия для бизнеса. Мы определим, каких доказательств не хватает, и сформируем наименьшую ответственную работу по масштабированию.

Мы используем файлы cookie для обеспечения безопасности и корректной работы нашего сайта. С вашего согласия мы также используем необязательные файлы cookie для аналитики и рекламных целей. Вы можете принять или отклонить использование необязательных файлов cookie. Вы можете изменить свои настройки в любое время. Подробнее — в нашей Политике использования файлов cookie.