/ 01
Перед запуском или ожидаемым ростом спроса
Проверьте самые ценные пути при прогнозируемом трафике, ожидаемой форме пика, задержке масштабирования и порогах отказа до того, как спрос поставит под угрозу клиентов, работу и выручку.
Реальная нагрузка · связанная телеметрия · безопасное проведение · повторяемое сравнение
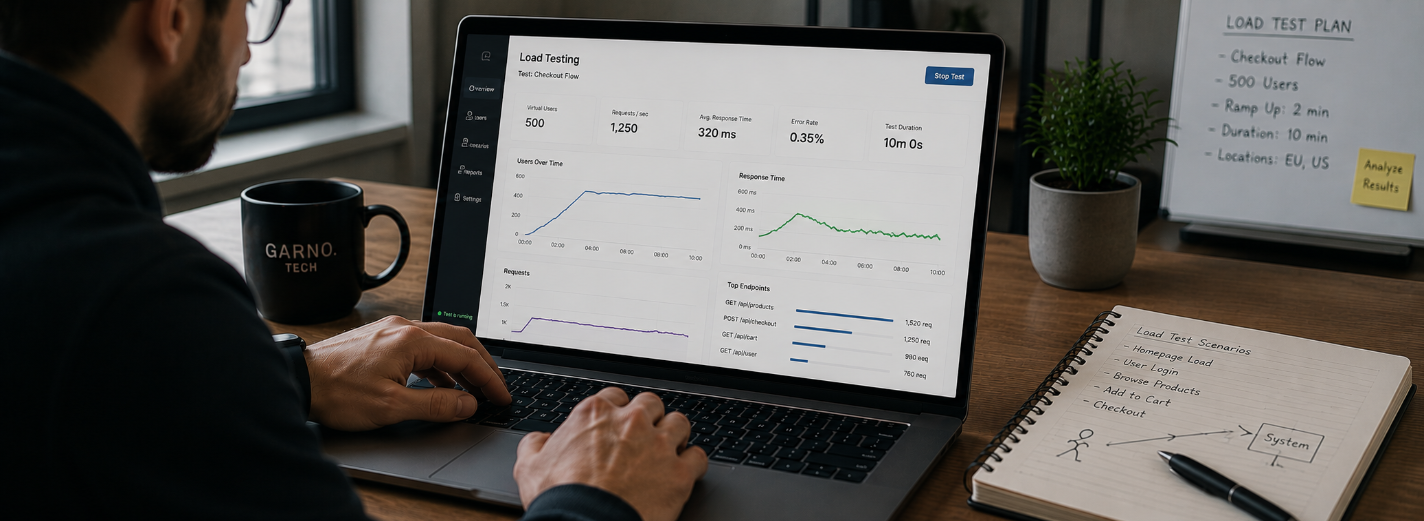
Нагрузочное испытание полезно тогда, когда влияет на решение. Оно может показать, уложится ли оформление заказа в целевую задержку во время кампании, сколько заданий обработает очередь до накопления отставания, какая зависимость первой исчерпает ресурс, успеет ли автоматическое масштабирование и вызвало ли недавнее изменение ухудшение. Большое число запросов без модели нагрузки, телеметрии системы и четких условий успеха или остановки создает лишь видимость работы вместо доказательств мощности.
Мы строим испытания быстродействия вокруг критических деловых путей и рабочей системы, которая их обслуживает. Результаты со стороны клиента сопоставляем с сигналами приложения, базы данных, временного хранилища, очередей, сети, инфраструктуры и внешних зависимостей. Работа завершается воспроизводимыми сценариями, выводами в установленных границах, упорядоченными по важности действиями и повторной проверкой в тех же условиях, а не голословным обещанием, что платформа выдержит произвольное число «пользователей».
Испытание средней нагрузкой проверяет обычный длительный спрос и создает исходный уровень для последующих сравнений. Стрессовое испытание поднимает спрос выше ожидаемого максимума, чтобы выявить ухудшение и поведение при восстановлении. Испытание резким всплеском внезапно увеличивает поток и показывает работу очередей, автоматического масштабирования, ограничения частоты и управления допуском. Длительное испытание достаточно долго удерживает нагрузку, близкую к реальной, чтобы найти рост потребления памяти, исчерпание запасов подготовленных ресурсов, разрастание журналов или хранилища, столкновение плановых задач и медленные утечки. Испытание предела или мощности повышает давление контролируемыми шагами до нарушения согласованной цели. Перед любым крупным запуском короткая проверка должна подтвердить исправность сценария и среды.
Сочетание испытаний определяет деловой вопрос. Перед запуском продукта могут понадобиться ожидаемый трафик и безопасный запас для стресса; продажа билетов требует резкого всплеска; платформа расчетов — длительной проверки через время выполнения плановых задач; а изменение API в CI — короткой проверки на ухудшение. Сценарии на уровне протокола эффективно создают серверный трафик, тогда как браузерные измерения показывают отрисовку страницы и опыт пользователя, но дороже масштабируются. Сочетанный подход часто создает основной объем через протокол и добавляет несколько браузерных путей для наблюдения за настоящей клиентской частью.
«Одновременные пользователи» еще не являются моделью нагрузки. Нужны интенсивность поступления, доли разных путей, темп и паузы пользователей, продолжительность сеанса, распределение данных, состояние временного хранилища, география, предположения об устройствах и сети, аутентификация, повторы, фоновые задачи и продолжительность испытания. По возможности мы выводим их из рабочей аналитики, прогнозов и событий продукта и явно описываем неопределенность. Так команда получает модель с независимым потоком новых операций или с фиксированным числом одновременных пользователей, которую можно рассмотреть, оспорить и воспроизвести.
Ответственное испытание начинается с разрешения и выбора среды. Нерабочая среда предпочтительнее, если по своим свойствам достаточно точно воспроизводит топологию, настройки, объем данных, квоты, интеграции, наблюдение и масштабирование, необходимые для ответа. Испытание рабочей системы иногда необходимо для проверки настоящего пути, но его можно проводить лишь с явным письменным разрешением, назначенными ответственными за эксплуатацию, рассмотренным сценарием, согласованным окном изменений, средствами защиты клиентов, координацией с поставщиками, непрерывным наблюдением, условиями остановки, действиями по восстановлению и планом коммуникации.
Подготовьте искусственные или обезличенные данные, которые сохраняют число уникальных значений и характер запросов, но не раскрывают личную или регулируемую информацию. Создайте испытательные учетные записи, безопасные повторяемые настройку и очистку, контролируемые учетные данные, сетевой доступ, списки разрешенных IP-адресов, достаточную мощность генераторов и способ отмечать испытательный трафик в журналах. Убедитесь, что электронная почта, SMS, платежи, проверки личности, внешние вызовы, аналитика, средства противодействия мошенничеству и другие сторонние службы разрешают такой трафик. Замените зависимость имитацией или моделью, если прямая нагрузка запрещена, дорога, опасна или исказит доказательства.
До начала определите безопасные пределы: наибольшую частоту запросов или операций, пороги ошибок и задержки, насыщение инфраструктуры, глубину очереди, давление на базу данных, предельные расходы, клиентские сигналы, продолжительность и человека, уполномоченного остановить работу. Выполните короткую проверку, откалибруйте генераторы, чтобы они сами не стали узким местом, сверьте время и телеметрию и зафиксируйте показатели системы без нагрузки. Большая нагрузка способна вызвать настоящую аварию, поэтому безопасность является частью замысла эксперимента, а не оговоркой в конце.
Отдельно измеряйте предложенную нагрузку и завершенную работу. Записывайте итерации, запросы, операции, байты, активные сеансы, скорость поступления, пропускную способность, повторы и отброшенную работу. Показывайте задержку как распределение — например, медиану, p90, p95 и p99 — для каждого пути и запроса, ведь среднее скрывает опасный «хвост». Различайте ошибки по классу и деловому смыслу: быстрый ответ 429, истекшее время ожидания, отклоненные данные, повторная операция и незаметный неверный ответ требуют разных решений. Проверяйте важное содержимое ответа, чтобы страница ошибки с кодом HTTP 200 не засчитывалась как успех.
Сопоставляйте клиентские наблюдения с серверными данными: трассировкой приложения, загрузкой процессора, памятью, сборкой мусора, давлением на потоки или цикл событий, запасами открытых соединений, перезапусками контейнеров, автоматическим масштабированием, сетевыми ограничениями, долей попаданий во временное хранилище, задержкой и блокировками запросов к базе данных, ограничением хранилища, глубиной и возрастом очереди, последующими вызовами, ограничениями частоты и средствами отсечения неисправных зависимостей. Помечайте запуски, версии, сценарии и запросы устойчивыми идентификаторами. Согласованные по времени сигналы превращают фразу «испытание замедлилось» в причинное предположение о первом ограниченном ресурсе и дальнейшем распространении последствий.
Наблюдайте за восстановлением так же осознанно, как за наращиванием нагрузки. Когда спрос падает, опустошаются ли очереди, возвращаются ли к норме запасы соединений и память, безопасно ли уменьшается число ресурсов, прекращаются ли повторы, отключаются ли средства отсечения неисправных зависимостей, восстанавливаются ли временные данные и продолжаются ли плановые задачи? Служба, которая достигла высокого максимума, но требует ручного ремонта, не доказала устойчивой мощности. Сравнивайте результаты лишь в объявленных границах: среда, версия, данные, состав нагрузки, места генераторов, продолжительность, состояние временного хранилища и пороги. Мощность — это условный рабочий диапазон, а не постоянное свойство системы.
Вы получаете запись решения с вопросом, проверенной архитектурой, версиями, предположениями, исключениями, рисками и границами применимости. Модель нагрузки описывает пути, поступление или одновременность, темп, данные, аутентификацию, прогрев, наращивание, устойчивый режим, этапы всплеска или стресса, восстановление и условия успеха. Воспроизводимые сценарии и настройки хранятся в системе управления кодом вместе с инструкциями подготовки, безопасными параметрами, правилами работы с испытательными данными, ожиданиями относительно секретов и требованиями к генераторам. Команда сможет повторить эксперимент после изменений в коде, инфраструктуре или трафике.
Пакет результатов содержит клиентские показатели, проверки деловых операций, согласованную по времени телеметрию системы, примеры неудачных запросов, доказательства насыщения, поведение при восстановлении, отклонения и границы уверенности. Мы отделяем наблюдения от выводов и отмечаем пробелы, где телеметрия не доказывает причины. Рекомендации упорядочиваем по ожидаемому влиянию, доказательствам, сложности, риску и способу проверки каждого изменения. Самым ценным исправлением может быть запрос к базе или правило временного хранения, но им также может оказаться управление допуском, ограничение очереди, согласование времени ожидания, заблаговременное масштабирование, уменьшение данных, распределение данных или точнее сформулированная цель службы.
Исходный уровень приобретает ценность в сравнении. Мы сохраняем сценарий и важное состояние среды, а после изменений повторяем согласованные этапы. Сравнение охватывает пропускную способность, задержку по процентилям, ошибки, потребление ресурсов, восстановление и стоимость полезной операции, а не восхваляет один улучшенный график. Результаты не распространяют выводы за проверенные границы и отличают ограничения системы от пределов генераторов, ограничений внешних служб, данных, не воспроизводящих реальные условия и различий среды.
Отчет об испытании должен входить в цикл инженерных решений. Сначала устраните пробелы в измерениях и ошибки правильности: показателям быстродействия нельзя доверять, когда ответы неверны или исчезают трассировки. Затем работайте с первым узким местом, а не настраивайте каждый видимый показатель. Проверьте изменение тем же сценарием, выясните, переместилось ли узкое место, и повторяйте, пока цель не будет достигнута или не станет ясна экономическая граница. Зафиксируйте принятые ограничения и правила работы с трафиком сверх них.
Добавляйте небольшие стабильные испытания в важные точки поставки. Короткая проверка быстродействия может защищать критический API в CI; регулярное измерение исходного уровня — выявлять постепенное отклонение; испытание кандидата на выпуск — проверять инфраструктуру и настройки; а более крупные стрессовые, пиковые и длительные упражнения — предшествовать рискованным событиям. Пороги должны выражать цели службы и известные бюджеты, реагировать на значимую задержку по процентилю, ошибки или пропускную способность и не создавать неустойчивых препятствий на основе шумной среды. Пересматривайте сценарии как рабочий код, когда меняются пути, аутентификация, данные, API или трафик.
Рекомендации может воплотить ваша команда, либо GARNO.TECH может отдельно поддержать масштабирование продукта, улучшение серверной части на NestJS или изменение архитектуры Azure. Внедрение остается необязательным. Работа по нагрузочному тестированию завершена, когда решение опирается на воспроизводимые доказательства, команда понимает границы, а у согласованных улучшений есть надежный путь проверки.
Покажите критический путь, ожидаемый спрос, действующую архитектуру, доступную среду, телеметрию и решение, которое должно поддержать испытание. Мы определим наименьший ответственный объем, способный дать воспроизводимые доказательства.