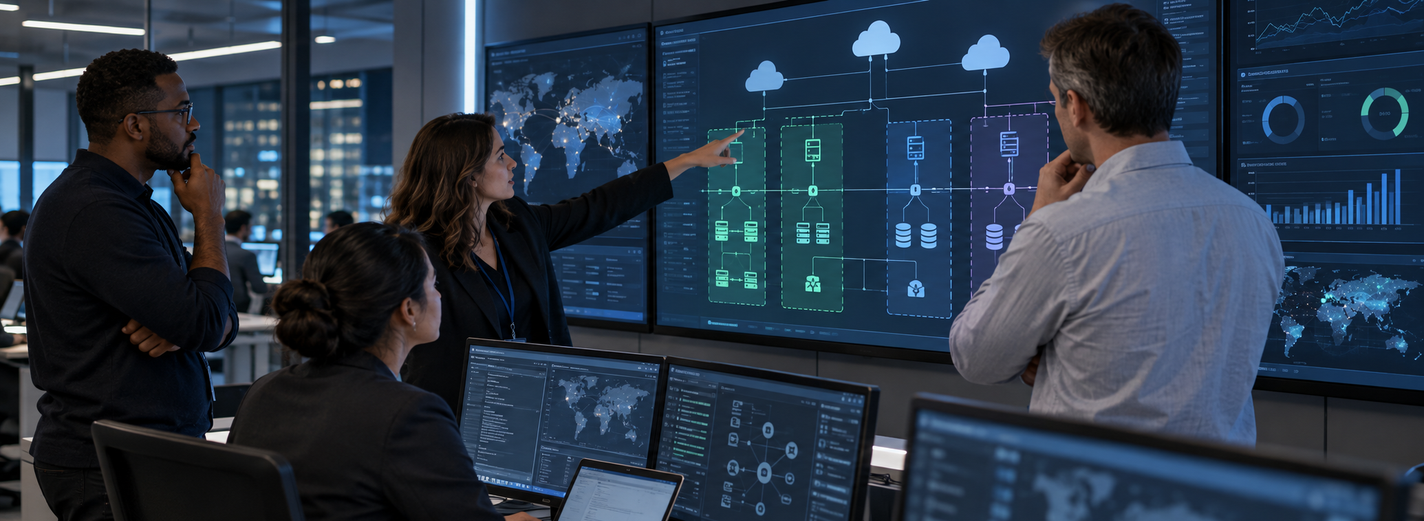
Архитектура целевой зоны Azure: руководство для промышленной эксплуатации
- Azure landing zone architecture
- azure
- architecture
- development
Целевая зона Azure — это управляемая основа, в которой развёртывают рабочие нагрузки. Она заранее определяет границы ответственности, правила идентификации и доступа, сетевую связность, требования к защите, телеметрию, восстановление и учёт расходов — ещё до того, как прикладные команды столкнутся с давлением рабочей эксплуатации. Это не застывшая схема и не набор модных служб Azure. Её ценность состоит в воспроизводимом пути: команда получает среду, безопасно развёртывает решение, поддерживает его и подтверждает соответствие требованиям бизнеса.
Начните со структуры организации и её рабочих нагрузок. Опишите подразделения, регуляторные и региональные границы, платформенные и прикладные команды, критически важные пользовательские пути, классы данных, сетевые связи, цели доступности и восстановления, распределение расходов, способ развёртывания и обязанности поддержки. Определите, какие средства контроля должны наследоваться централизованно, какие относятся к отдельной нагрузке и когда истекают исключения. Используйте рекомендации Azure Landing Zone и принципы Well-Architected Framework как ориентир, но приспосабливайте решение к реальному масштабу и возможностям команды.
Сформулируйте успех на языке эксплуатации: время подключения новой нагрузки, соблюдение правил, проверка привилегированного доступа, доля успешных развёртываний, полнота телеметрии, подтверждённое восстановление, отнесение расходов и срок действия исключений. Целевая зона готова тогда, когда типовая команда может пройти документированный автоматизированный путь, а платформенная команда — надёжно его поддержать. Самого наличия облачных ресурсов для этого недостаточно.
Что даёт целевая зона, готовая к промышленной эксплуатации
Основа должна обеспечивать понятную структуру среды организации и групп управления, автоматизированное предоставление подписок, устойчивые способы идентификации и привилегированного доступа, сетевую связность и DNS, обязательные правила, централизованные сведения о безопасности и работе систем, упорядочение ресурсов, бюджеты, автоматизацию и ясные условия подключения. Нужно также определить порядок повышения уровня реагирования на инциденты, обслуживания платформы, обязанности по восстановлению и способ, которым команды запрашивают исключение или новую общую возможность.
Отделите платформенные услуги от обязанностей команд рабочих нагрузок. Платформенная команда может отвечать за связность, правила, общее журналирование и предоставление подписок, тогда как прикладная команда — за авторизацию в своём приложении, жизненный цикл данных, целевые показатели службы, развёртывание и восстановление работы. На каждой границе следует прямо закрепить совместную ответственность. Фраза «за безопасность отвечает облачная команда» не заменяет рабочей модели.
Проверьте основу на типовой рабочей нагрузке. Проследите путь цифрового удостоверения от разработчика через конвейер развёртывания до среды выполнения, проверьте движение сетевого трафика и DNS, разверните инфраструктуру из кода, намеренно нарушьте правило, изучите журналы и расходы, отработайте инцидент и удалите нагрузку. Такая проверка покажет, действительно ли документация, разрешения и порядок обращения за помощью соответствуют архитектуре.
Стройте группы управления и подписки по границам ответственности
Группы управления упорядочивают наследование правил и доступа. Они должны отражать устойчивые различия в управлении, а не копировать меняющуюся организационную схему. Не делайте иерархию чрезмерно глубокой. Обычно достаточно различать платформу, рабочие нагрузки целевой зоны, экспериментальные и выведенные из эксплуатации подписки. Добавляйте ветви только из-за реальных регуляторных требований, требований к суверенитету данных или особых условий эксплуатации. До широкого применения проверьте наследование и исключения.
Подписка служит границей управления, оплаты, квот и масштаба возможных последствий. Разделяйте нагрузки или среды, если им нужны разные ответственные, правила, бюджеты, жизненные циклы, ограничения либо изоляция во время инцидента. Не объединяйте несвязанные команды в одной огромной рабочей подписке, но и не создавайте отдельную подписку для каждой мелкой составляющей: это лишь умножает администрирование. Запишите критерий разделения, чтобы с ростом организации границы оставались последовательными.
Автоматизируйте предоставление подписки вместе с назначением ответственного, цели, среды, центра расходов, контактов, набора правил, сетевых потребностей, места хранения журналов, бюджета и, где требуется, срока действия. Квоты и доступность служб в регионах — реальные ограничения ёмкости, а не второстепенные подробности. Порядок завершения работы должен охватывать архивирование доказательств, перенос или удаление данных, удаление маршрутов и учётных данных, исполнение финансовых обязательств и прекращение расходов.
Группируйте ресурсы по жизненному циклу, а доверие стройте на идентификации
Объединяйте в группу ресурсы с общим жизненным циклом, способом развёртывания, доступом и эксплуатационным владельцем. Группа ресурсов — не папка; она не создаёт ни сетевой изоляции, ни отдельной зоны отказа. Размещайте ресурс с учётом того, кто его изменяет, наблюдает за ним, оплачивает и удаляет. Названия и метки помогают поиску и автоматизации, однако там, где важна точность, опирайтесь на правила и перечень ресурсов под управлением системы версий.
Доверие к сотрудникам и программным нагрузкам закрепите в Microsoft Entra ID. Предоставляйте доступ группам, а не отдельным пользователям; применяйте управляемые цифровые удостоверения вместо хранимых секретов приложений и узкие роли вместо широких прав участника. Защищайте привилегированные роли надёжной аутентификацией, ограниченным по времени повышением прав, согласованием там, где оно оправдано, и контролируемыми аварийными учётными записями. По установленному расписанию проверяйте гостей, служебные приложения, устаревшие учётные данные и назначенные роли.
Создавайте собственные роли лишь тогда, когда встроенные не способны точно выразить обязанности, и проверяйте разрешения как на данные, так и на средства управления. Отделите право конвейера развёртывать изменения от человеческого администрирования и поддержки рабочей среды. У каждого цифрового удостоверения должны быть ответственный, назначение, область действия, способ аутентификации или объединения доверия, дата проверки и понятный путь отзыва.
Сделайте сетевую связность, DNS и защиту управляемыми
Выбирайте устройство сети по потокам данных и ответственности, а не по типовой картинке. Схема с центральным узлом и ответвлениями либо Virtual WAN позволяют централизовать общую связность в разных масштабах, однако оба варианта требуют продуманных маршрутов, межсетевых экранов, DNS и эксплуатации. Опишите входящие, исходящие, внутренние и гибридные потоки, ожидаемую пропускную способность, задержку, доступность, проверку трафика и стоимость. Назначьте ответственных за адресное пространство, маршруты, частные конечные точки, сертификаты и внешние списки разрешённых адресов.
DNS входит в цепочку зависимостей приложения. Определите владельцев общедоступных и частных зон, пересылку запросов, доступность серверов разрешения имён, разные ответы на внутренние и внешние запросы, жизненный цикл записей и разрешение имён в гибридной сети. Частная связность создаёт дополнительные эксплуатационные зависимости; она не заменяет идентификацию, авторизацию и защиту данных. Проверяйте разрешение имён и маршруты из каждой нужной среды, включая сценарии отказа.
Сокращайте масштаб возможных последствий с помощью сегментации и явно заданного доверия, а работу защитных средств делайте наблюдаемой. Защищайте административный доступ, ограничивайте неконтролируемый исходящий трафик, если того требует модель угроз, записывайте существенные сетевые решения и репетируйте аварийные изменения. Не стройте централизованную проверку трафика, если её ёмкость, доступность или ответственность за неё слабее нагрузок, которые она должна защищать.
Развивайте правила и телеметрию как полноценные продукты
Azure Policy превращает цели управления в предупреждающие правила, проверки или автоматическое исправление. Начните с небольшого набора, связанного с существенными рисками: разрешённые регионы, обязательная диагностика, открытость для общего доступа, одобренные типы ресурсов, шифрование, метки и защищённые настройки. Описывайте правила кодом, проверяйте их на типовой области, сначала применяйте режим наблюдения там, где это уместно, разбирайте ложные срабатывания и лишь затем принудительно обеспечивайте выполнение. Для каждого исключения нужны обоснование, ответственный, узкая область действия, дополнительная защитная мера и конечная дата.
Централизованная телеметрия должна служить конкретным задачам эксплуатации. Определите, какие сигналы о действиях, цифровых удостоверениях, безопасности, сети, платформе и нагрузках собираются; кто может делать запросы; сколько и где хранятся данные; кто выявляет события и реагирует на них; каковы пределы расходов. Направляйте требующие действия оповещения дежурной команде с указанием важности и порядка исправления. Журналы, недоступные во время инцидента, почти ничего не доказывают.
Измеряйте работу самой платформы: время подключения, неудачные развёртывания, соблюдение правил и исключения, привилегированные изменения, пробелы в журналировании, реагирование на инциденты, проверки восстановления и распределение расходов. Относитесь к наборам правил, информационным панелям и условиям оповещения как к продуктам с управляемыми версиями, испытаниями и описанием изменений. Изменение наследуемого правила может затронуть каждую нагрузку, поэтому внедряйте его поэтапно.
Разделяйте среды и воспроизводите их с помощью IaC
Рабочим и нерабочим средам нужны границы, соразмерные риску. Разделяйте цифровые удостоверения, данные, секреты, сетевые пути, правила, бюджеты и разрешения на развёртывание везде, где случайное изменение способно проникнуть в рабочую среду. Не копируйте чувствительные рабочие данные в среду разработки без веской причины; используйте созданные для испытаний, обезличенные или контролируемые наборы с правилами доступа и сроками хранения.
Описывайте иерархию управления, правила, назначения ролей, связность, общие службы, диагностику и предоставление подписок в виде модульной инфраструктуры как кода (IaC). Фиксируйте версии, проверяйте планы изменений, защищайте состояние, испытывайте модули и последовательно продвигайте изменения через типовые среды. Выявляйте расхождения между кодом и фактическим состоянием и решайте, устранить их или документировать как аварийное исключение. Изменения через консоль требуют тех же доказательств и последующего упорядочения, что и изменения в коде.
Заранее продумайте обновление и возврат к предыдущей версии платформенных модулей. Несовместимое правило или маршрут может иметь более широкие последствия, чем выпуск приложения. Используйте интерфейсы с явными версиями, поэтапное принятие, периоды совместимости и заблаговременное оповещение команд-потребителей. Воспроизведение части нерабочей среды только из исходного кода убедительно доказывает, что целевую зону действительно можно восстановить.
Сдерживайте сложность платформы ясными условиями подключения
Сложность платформы оправдана лишь тогда, когда она устраняет повторяющийся риск или ручную работу прикладных команд. Не добавляйте межсетевые экраны, кластеры, шлюзы, регионы, собственные роли или уровни правил без конкретного требования, ответственного, целевого уровня службы и средств на эксплуатацию. Управляемые службы снимают часть обязанностей, но приносят квоты, жизненный цикл продукта, зависимость от поставщика и новые виды отказов. Сравнивайте каждое решение с самым простым надёжным вариантом для ожидаемого масштаба.
Опубликуйте условия подключения: какие сведения предоставляет команда нагрузки, что она получает от основы, какие правила наследует, за что продолжает отвечать, какие доказательства нужны для рабочей эксплуатации, куда обращаться за помощью, как учитываются расходы и как согласуется исключение. Предложите стандартные, хорошо поддерживаемые пути для распространённых типов нагрузок, но разрешайте обоснованное отступление. Удобство для разработчика тоже служит средством контроля: если платформу невозможно вовремя понять или использовать, команды начнут её обходить.
Пересматривайте целевую зону после подключения типовых нагрузок, инцидентов, проверок, значительных изменений Azure и роста организации. Выводите из эксплуатации ненужные общие службы и объединяйте правила, которые больше не соответствуют отдельному риску. Целостность архитектуры поддерживают названные решения и своевременное удаление лишнего, а не непрерывное накопление.
Когда полезна независимая экспертиза по Azure
Независимая проверка полезна, когда архитектура охватывает несколько подразделений или регионов, опирается на уязвимую унаследованную среду организации, обрабатывает регулируемые данные, вводит сложную гибридную связность либо должна преодолеть беспорядок в правилах и доступе. Она также уместна перед широким принудительным применением правил, крупным переносом систем или передачей платформы другой команде, когда одна ошибка способна затронуть множество нагрузок.
Попросите эксперта проверить реальные сценарии и материалы: иерархию и наследование, запрос на подписку, привилегированный доступ, развёртывание, частный DNS, получение журналов, исключение из правила, распределение расходов, реагирование на инцидент и завершение использования. Результатом должен стать упорядоченный по важности реестр решений с доказательствами, последствиями для бизнеса, ответственным, условиями приёмки и безопасным порядком внедрения, а не общая оценка зрелости.
GARNO.TECH может оценить существующую основу, спроектировать минимально достаточную целевую зону, внедрить модули с управляемыми версиями или помочь платформенной команде провести первую типовую нагрузку через разработку облачных решений в Azure. Право собственности, хранилища кода и учётные записи остаются под контролем клиента, а передача знаний и возможность завершить сотрудничество закладываются с самого начала.
- Границы: определите правила для среды организации, групп управления, подписок и групп ресурсов с учётом управления, жизненного цикла, ответственности и масштаба возможных последствий.
- Идентификация: применяйте группы, управляемые цифровые удостоверения, наименьшие необходимые права, ограниченное по времени повышение доступа, аварийные учётные записи и плановые проверки.
- Связность: опишите трафик и DNS, ёмкость, проверку, гибридные зависимости, доступность, стоимость и ответственных за эксплуатацию.
- Обязательные правила: внедряйте правила с управляемыми версиями и исключения постепенно, вместе с телеметрией, ответственными, конечными датами и проверенным исправлением.
- Автоматизация: предоставляйте подписки и общие средства контроля через проверенную IaC, защищённое состояние, испытания модулей, устранение расхождений и возврат к предыдущей версии.
- Подключение: на типовой нагрузке докажите работоспособность развёртывания, эксплуатации, восстановления, распределения расходов, исключений и завершения использования.
Что такое целевая зона Azure?
Что такое целевая зона Azure?
Каждой ли компании нужна сложная корпоративная целевая зона?
Каждой ли компании нужна сложная корпоративная целевая зона?
Как разделять подписки Azure?
Как разделять подписки Azure?
Стоит ли сразу принудительно применять все правила?
Стоит ли сразу принудительно применять все правила?
Как понять, что целевая зона готова к рабочей эксплуатации?
Как понять, что целевая зона готова к рабочей эксплуатации?
Постройте защищённую основу Azure до роста нагрузок
Предоставьте структуру среды организации, перечень действующих подписок, требования к идентификации и доступу, сетевые связи, типы нагрузок, обязательные правила и модель эксплуатации. GARNO.TECH определит минимально достаточную основу и спланирует проверочное подключение типовой нагрузки с ясной ответственностью, условиями приёмки и порядком внедрения.
Публикации
Наши исследования
Исследование и разработка решений на основе искусственного интеллекта для оптимизации бизнес-процессов и повышения эффективности принятия решений.
Анализ моделей машинного обучения для прогнозной аналитики в сфере финансов, электронной коммерции и SaaS-платформ.
Исследование технологий обработки естественного языка и компьютерного зрения для усиления автоматизации, персонализации и поддержки клиентов.
Стратегия тестирования Angular: выбирайте доказательства с учётом рисков продукта
Практическое руководство по тестированию Angular: чистая логика, компоненты, доступность, договоры API, критические сквозные пути, испытательные данные, время, нестабильные проверки и поэтапная обратная связь CI.
11 мин чтения
08 Sep 2026
Как спланировать серверную часть на NestJS: границы, архитектура и реализация
Практическое руководство по планированию серверной части на NestJS вокруг деловых возможностей, договоров API, ответственности за данные, безопасности, взаимодействия с системами, фоновой работы, эксплуатации и измеримых этапов.
8 мин чтения
05 Aug 2026
Что происходит после MVP: от проверки идеи до масштабируемого продукта
Превратите доказательства, полученные благодаря MVP, в целенаправленный план развития ценности продукта, архитектуры, надёжности, ответственности команды, возможностей SaaS, экономики и управляемого роста.
10 мин чтения
05 Aug 2026